「Qwen3.8-27B」マルチモーダル視覚言語モデル:当サイトでの回答例・必要VRAM 8GB〜・GGUF版あり
基本情報
| 項目 | 内容 |
|---|---|
| リポジトリ | Qwen/Qwen3.8-27B |
| まとめページ | Qwen3.8 のまとめ(記事8本) |
| 公開元のまとめ | Alibaba(Qwen) のモデルとライセンスのまとめ |
| 公開日 | 2026-08-05 |
| ライセンス | apache-2.0 |
| 配布形式 | safetensors |
| 出典の種類 | 公開元の一次情報(公式Qwen組織のHFリポジトリが一次情報) |
情報を集めた時点で、当サイトのコードが確定させた値です。日付はJSTで表示しています。
当サイトで確かめたこと
- GPU の無い当サイトのサーバー(Neoverse-N1・3スレッド・llama.cpp b11223)で
Qwen3.8-27B-UD-IQ3_XXS.gguf(IQ3_XXS)を動かし、生成は 0.6 トークン/秒でした(CPU での値で、GPU の速さの目安ではありません)。 - 固定の日本語の質問への回答を、下に原文のまま載せています。
- Qwen3 のトークナイザより約21%少ないトークンで同じ日本語を表せます。同じ文脈長に入る日本語が約1.26倍になり、生成も1字あたりで速くなります。
詳しい値と条件は、下の「当サイトでの実測」の節にあります。
概要
Qwen チームが、Qwen のオープンモデルの新世代 Qwen3.8 の中核として、27B の Dense モデル Qwen3.8-27B を Hugging Face で公開しています。モデルカードは Qwen3.8 を「Qwen のオープンモデルのうち、これまでで最も高性能な世代」と位置づけており、Qwen3.5 のアーキテクチャを土台に、コーディング・業務タスク・調査・長い手順を要するエージェント作業で大きく伸びたとしています。画像と動画を理解できる視覚言語モデル(VLM)で、思考(thinking)の有無と深さをリクエストごとに切り替えられます。
このモデルを元にした量子化版・ファインチューンが次々と公開されており、当サイトでも派生版を7本取り上げてきましたが、元になった本体の記事はこれが最初になります。
スペック
- パラメータ数: 27B(言語モデル部分。視覚エンコーダを別に持つ)
- アーキテクチャ: Dense。64 層で、「Gated DeltaNet → FFN」を3回、「Gated Attention → FFN」を1回という4層の組を16回重ねるハイブリッド構成です。つまり 64 層のうち 48 層が線形アテンション(Gated DeltaNet)、16 層が通常のアテンション(Gated Attention)になります
- Gated DeltaNet: 線形アテンションのヘッドは V が 48・QK が 16、ヘッドの次元は 128
- Gated Attention: アテンションのヘッドは Q が 24・KV が 4、ヘッドの次元は 256、RoPE の次元は 64
- 隠れ層の次元: 5,120。FFN の中間次元: 17,408
- 語彙(埋め込み・出力): 248,320(パディング込み)
- MTP(Multi-Token Prediction): 複数ステップで学習済み
- コンテキスト長: ネイティブで 262,144 トークン。YaRN で最大 1,000,000 トークンまで拡張できる
- 入力: テキスト・画像・動画(視覚エンコーダ付きの Causal Language Model)
性能
モデルカードは、テキストと視覚(VL)の2つの比較表を載せています。比較対象は前世代の Qwen3.6-27B、Qwen3.7-Plus、Muse Glimmer-30B、Opus4.6 Max の4つで、いずれも公開元自身が公表した数値です(「–」は結果が無い、または対象外)。
テキストの性能(モデルカードの表をそのまま転記)
→ 横にスクロールできます
| Qwen3.8-27B | Qwen3.6-27B | Qwen3.7-Plus | Muse Glimmer-30B | Opus4.6 Max | |
|---|---|---|---|---|---|
| Coding | |||||
| Agentic terminal coding Terminal Bench 2.1 (Terminus) | 73.0 | 63.4 | 64.0 | 51.7 | 78.2 |
| Agentic coding SWE-bench Pro | 61.7 | 53.5 | 57.6 | 51.2 | 53.4 |
| Repo-level code generation NL2Repo-Bench | 42.3 | 36.2 | 41.1 | — | 47.6 |
| Agentic coding DeepSWE 1.1 | 42.2 | 13.3 | 14.2 | — | — |
| Software engineering QwenSWEBench | 79.0 | 49.3 | 59.2 | — | 63.8 |
| Agent | |||||
| Long-horizon office work CoWorkBench | 70.7 | 61.0 | 65.1 | — | 68.2 |
| Professional job tasks JobBench | 33.4 | 21.8 | 27.6 | — | — |
| Frontier agentic tasks Agents’ Last Exam | Pass@1 20.4 Score 42.9 | Pass@1 10.6 Score 27.3 | Pass@1 13.2 Score 33.6 | — | — |
| General | |||||
| Instruction following IFBench | 79.5 | 69.1 | 79.1 | 77.0 | 62.5 |
| Scientific reasoning GPQA Diamond | 89.2 | 87.8 | 90.3 | 83.5 | 91.3 |
| Multidisciplinary reasoning HLE | 30.8 | 24.0 | 34.7 | 22.0 | 40.0 |
| Competitive coding LiveCodeBench v6 | 90.3 | 83.9 | 89.6 | — | 88.8 |
モデルカードによれば、前世代の Qwen3.6-27B に対しては全ての行で上回っています。伸びが大きいのはエージェント型のコーディングで、DeepSWE 1.1 は 13.3 から 42.2 へ3倍以上、公開元の社内ベンチマークである QwenSWEBench は 49.3 から 79.0 へ上がりました。SWE-bench Pro(実在の GitHub の issue をリポジトリを編集して解決できたかの割合)は 61.7 で、比較対象の中で最も高いです。一方、ターミナルで作業を最後までやり切れるかを見る Terminal Bench 2.1 は 73.0 で Opus4.6 Max(78.2)に 5.2 ポイント及ばず、博士課程レベルの科学の難問 GPQA Diamond(89.2)と専門家が作った超難問集 HLE(30.8)は Qwen3.7-Plus・Opus4.6 Max のどちらよりも低いです。HLE では Opus4.6 Max と 9.2 ポイントの差があります。「実際に手を動かしてやり切るコーディング・業務作業」で強く、「知識と推論の難問」では上位のモデルに届かないというのが表から読める傾向です。競技プログラミングの新作問題を集めた LiveCodeBench v6 は 90.3 で、比較対象の中で最高値でした。
ただし、比較の条件には注意が要ります。モデルカードの注記によれば、SWE-bench Pro は Opus4.6 Max だけが公式に報告された値で、それ以外のモデルは Claude Code のハーネスで評価し直した値です。QwenSWEBench・CoWorkBench は Qwen チームの社内ベンチマークで、第三者が同じ条件で再現できる評価ではありません。
視覚(VL)の性能(同じくモデルカードの表を転記)
→ 横にスクロールできます
| Qwen3.8-27B | Qwen3.6-27B | Qwen3.7-Plus | Muse Glimmer-30B | Opus4.6 Max | |
|---|---|---|---|---|---|
| Agentic Multimodal Intelligence | |||||
| Computer use OSWorld-Verified | 84.3 | 63.9 | 73.3 | 65.9 | 72.7 |
| Browser use WebArena-Verified | 64.8 | 48.8 | 55.3 | — | — |
| Mobile use AndroidWorld | 81.9 | 70.3 | 81.0 | — | 62.0 |
| Application recreation RecreationBench | 47.1 | 29.8 | 30.2 | — | — |
| Multimodal tool use ClawEval-MM | Pass@3 57.4 Average 56.9 | Pass@3 42.6 Average 50.4 | Pass@3 57.4 Average 60.1 | — | Pass@3 52.5 Average 54.7 |
| Multimodal software engineering SWE-MM | 38.6 | 25.7 | 30.0 | — | 27.1 |
| Visual web development Vision2Web | 62.9 | 45.0 | 42.1 | — | — |
| General Multimodal Intelligence | |||||
| Visual math problem solving MathVision | Without CI 90.0 With CI 94.6 | Without CI 85.1 | Without CI 90.3 | — | Without CI 65.5 |
| General visual reasoning BabyVision | Without CI 65.7 With CI 85.6 | Without CI 28.9 | Without CI 64.7 With CI 70.4 | — | Without CI 12.6 |
| Scientific chart analysis CharXiv (RQ) | Without CI 83.7 With CI 90.2 | Without CI 78.4 | Without CI 85.8 With CI 85.9 | 78.8 | Without CI 66.0 |
| Document intelligence OmniDocBench 1.5 | 91.1 | 89.4 | 91.4 | 75.8 | 86.6 |
| Real-world perception RealWorldQA | 85.9 | 84.1 | 86.9 | — | 73.9 |
| Embodied intelligence ERQA | 65.5 | 62.5 | 69.8 | — | 40.8 |
視覚でも傾向は同じで、画面を見て操作する系のタスクで大きく伸びています。実際の OS の画面を操作してタスクを完了できるかを見る OSWorld-Verified は 84.3 で、Qwen3.7-Plus(73.3)・Opus4.6 Max(72.7)を 11 ポイント以上引き離しました。ブラウザ操作の WebArena-Verified(64.8)、画像を見ながらのソフトウェア開発 SWE-MM(38.6)、画面からウェブページを作る Vision2Web(62.9)も比較対象の中で最も高いです。一方で、文書の読み取り(OmniDocBench 1.5: 91.1 対 91.4)、実世界の写真の認識(RealWorldQA: 85.9 対 86.9)、身体性を伴う推論(ERQA: 65.5 対 69.8)、マルチモーダルのツール利用の平均スコア(ClawEval-MM: 56.9 対 60.1)では Qwen3.7-Plus に及びません。前者2つは1ポイント以内の僅差ですが、ERQA は 4.3 ポイントの差があります。MathVision・BabyVision・CharXiv の「With CI」はコード実行などの道具を使った場合の値で、「Without CI」とは条件が違います。比べるときは同じ条件の値同士で見る必要があります。
得意なこと・想定用途
モデルカードが掲げる強化点は、コーディング・業務タスク・調査・長い手順のエージェント作業の4つで、自律的な計画立てと、環境からのフィードバック(実行結果やエラー)を踏まえて作業を続ける能力の向上をうたっています。上の表でも、伸びが目立つのはリポジトリを編集して issue を解決する・ターミナルやブラウザ、OS の画面を操作するといった「最後までやり切る」種類のタスクであり、コーディングエージェントや PC 操作エージェントの頭脳として使う用途に最も向いています。モデルカードは「よく使われるハーネスや開発ツールへの対応を広げた」ことも強化点に挙げています。
視覚面では、STEM の図・文書から1時間規模の動画までを入力できます。動画を長く扱うときは、配布されている video_preprocessor_config.json の longest_edge を 469,762,048(224k の動画トークンに相当)に上げてフレームの取り方を細かくするよう、モデルカードが勧めています。
思考の制御は、次の3つの仕組みで行います。
- 思考モードは既定でオン。リクエストごとに
chat_template_kwargsのenable_thinking: Falseで切れる reasoning_effortで思考の深さをxhigh(既定)・medium・lowから選びます。ただしモデルカードは、複数ターンのエージェント作業では深さを下げても全体の所要時間が縮むとは限らない(分析が浅くなって失敗とやり直しが増え、かえってトークンを使う)と注意していますpreserve_thinkingは既定でオンで、過去のメッセージの思考ブロックを会話全体にわたって残します。エージェントの判断の一貫性を保ち、KV キャッシュの再利用も効きやすくなるとしています。直近の発話の思考だけを残したい場合はFalseにします
推奨のサンプリング設定は、思考モードで temperature=1.0・top_p=0.95・top_k=20・presence_penalty=0.0、非思考モードで temperature=0.7・top_p=0.80・top_k=20・presence_penalty=1.5 です。同じ文の繰り返しが止まらないときは presence_penalty を 0〜2 の範囲で上げられますが、上げすぎると言語が混ざったり性能がやや落ちたりすることがあるといいます。エージェント作業では出力の長さを十分に取るよう勧めており、思考部分は最大 262,144 トークン、最終応答は最大 131,072 トークンを目安に挙げています。
類似モデルとの違い
当サイトではこれまで、このモデルを元にした派生版を扱ってきました。たとえば 「Ternary-Bonsai-2-27B-gguf」テキスト生成モデル:当サイトでの回答例・必要VRAM 8GB〜 は、Qwen3.8-27B を1重みあたり実効 1.72 ビットの三値表現に作り直し、FP16 との性能差を抑えつつ小さな機材で動かすことを狙ったモデルです。Qwen3.8-27B-TWIN-TURBO-Fable-Cold-Fusion-709-L-Uncensored-NM-DAU-NEO-MTP-GGUF は、思考トークンを減らす方向に調整した個人のファインチューンです。いずれも本体の能力を前提に、サイズや思考の長さのどちらかを削っています。本体の Qwen3.8-27B は、上の表の性能を公開元の条件どおりに出せる基準点にあたります。
動作環境
動作環境の目安(Local Model Watch 算出) — パラメータ数 27.8B
| 手持ちのVRAM | 選べる量子化 | ファイルサイズ | 必要メモリの目安 |
|---|---|---|---|
| RTX 4060 / 3060 Ti など 8GB | IQ1_M | 6.3GB | 7.5GB |
| RTX 4070 / 3060 12GB など 12GB | Q2_K_XL | 9.2GB | 11.0GB |
| RTX 5060 Ti 16GB / 4060 Ti 16GB など 16GB | IQ4_XS | 13.3GB | 15.9GB |
| RTX 4090 / 3090 など 24GB | Q5_K_XL | 19.4GB | 23.3GB |
| RTX 5090 など 32GB | Q8_K_L | 26.1GB | 31.3GB |
| RTX 6000 Ada / A6000 など 48GB | Q8_K_XL | 29.3GB | 35.2GB |
| A100 / H100 80GB クラス | BF16 | 50.9GB | 61.1GB |
推論エンジンの対応状況(各プロジェクトのソースにあるモデル登録表とアーキテクチャ名を当サイトが機械的に照合。2026-11-11 時点): llama.cpp: 登録あり、vLLM: 登録あり、MLX (mlx-lm): 登録あり。
必要メモリは配布ファイルの実サイズに実行時のオーバーヘッド(KVキャッシュ等)を20%見込んだ概算で、文脈長・バッチサイズ・推論エンジンによって増減します。公開元の公称値ではなく、当サイトがファイルサイズから機械的に算出した値です。 ファイルサイズは変換版 unsloth/Qwen3.8-27B-GGUF の配布ファイルの実測値です。 他のモデルとの比較はVRAM別の早見表を参照してください。 量子化の名前の読み方は用語集にあります。
手元で動かせるか
Ollama・LM Studio・llama.cpp で動かせます(変換版を利用)。
公開元の配布は safetensors ですが、unsloth/Qwen3.8-27B-GGUF が GGUF版を公開しているため、そちらを使えば手元で動きます。
ライセンス apache-2.0(商用利用可): 商用利用を含めて自由に利用・改変・再配布できます。再配布時にライセンス文と変更点の告知が必要で、特許の許諾条項があります。
量子化の圧縮率: IQ4_XS は実測 4.11 bit/weight で、元の16bitの重みの約26%のサイズです(配布ファイルの実サイズから当サイトが算出)。
配布形式・当サイトが見つけた変換版・各推論エンジンの登録表を突き合わせた判定です。「確認できていない」は当サイトが見つけていないという意味で、存在しないことの断定ではありません。ライセンスの要約は法的助言ではないため、実際の利用にあたっては公開元の原文を確認してください。
当サイトでの実測
当サイトのサーバー(GPUなし)で、このモデルのファイルを実際に読み込み・動かして確かめた値です。モデルカードの記載ではなく、当サイトが測った結果です。測り方と全モデルの一覧は観測データにまとめています。
実測から分かったこと
Qwen3.8-27B は、4bit の配布が当サイトの CPU の実測の上限に収まらないため、ビット数の低い IQ3_XXS(10.18GB)で測りました。CPU だけでは生成が毎秒0.64トークン(日本語に直して毎秒約1.2字)、プロンプトの読み込みも毎秒0.72トークンと非常に遅く、ピーク時のメモリは14.5GBでした。同じ条件で Q4_K_M を測った Qwen3-8B(毎秒4.57トークン)と比べても大きく遅れます。
一方で、答えの確かさは際立っていました。当サイトが描いた画像の問いでは、グラフから土曜日の260人と平日の合計635人を、表から品目ごとの金額を4品目すべてと合計1,354円を正しく答えています。日本語の文章題も正解の280円で、要約は指示どおり3文でまとめました。
弱い点もあります。海に面していない県の問いでは8県のうち5県を挙げたものの、海に面した都道府県を4つ混ぜ、同じ行を9回繰り返して1,024トークンの上限で打ち切られました。敬語のメールには英単語が5語、文章題の答えには3語混ざっています。CPU だけの環境では、答えの確かさと引き換えに、待ち時間が大きく延びることを前提にする必要があります。
日本語のトークン効率
| トークナイザ | 日本語1,000字あたりのトークン数 | 同じ内容の英文との比 |
|---|---|---|
| このモデル | 546 | 0.99倍 |
| Qwen3 | 688 | 1.26倍 |
| Llama 3.2 | 744 | 1.36倍 |
| Gemma 3 | 564 | 1.03倍 |
| gpt-oss | 795 | 1.45倍 |
| LLM-jp-3 | 497 | 0.85倍 |
Qwen3 のトークナイザより約21%少ないトークンで同じ日本語を表せます。同じ文脈長に入る日本語が約1.26倍になり、生成も1字あたりで速くなります。
Qwen/Qwen3.8-27B の tokenizer.json で、当サイトが書き下ろした固定の文章(876字。ニュース・会話・技術文書・敬語のメール・紀行文・料理の6種)と、同じ内容の英文を数えました。トークン数が少ないほど、同じ文脈長に長い日本語が入ります。
GGUFファイルの中身
対象: Qwen3.8-27B-UD-Q4_K_M.gguf(15.33GB、Q4_K_M)。ファイルの先頭のメタデータだけを読んで確かめました(重みはダウンロードしていません)。
| 項目 | 値 |
|---|---|
| アーキテクチャ(GGUF上の名前) | qwen35 |
| 学習時の最大文脈長 | 262,144トークン |
| 層の数 | 65 |
| 語彙数 | 248,320 |
| チャットテンプレート | 同梱(ツール呼び出しの記述あり・思考の切り替えの記述あり) |
| imatrix | 使用(1,251チャンク) |
| 重みの型の内訳(パラメータ数の割合) | IQ4_XS 32.8% / Q4_K 27.4% / Q5_K 25.7% / Q6_K 8.1% / その他 6.0% |
| 平均のビット数 | 4.82ビット/重み |
| 埋め込み層 / 出力層の型 | Q4_K / Q6_K |
ファイル名の量子化名はファイル全体の呼び名で、実際には層ごとに型が混ざっています。平均のビット数は、ファイルのデータの大きさを重みの数で割った実測値です。
CPUだけで動かした結果
| 項目 | 結果 |
|---|---|
| プロンプトの読み込み(512トークン) | 0.7 トークン/秒 |
| 生成(128トークン) | 0.6 トークン/秒 |
| 生成を日本語の字数に換算 | 約1.2字/秒 |
| ピーク時のメモリ(文脈4,096トークン) | 14.5GB |
条件: Neoverse-N1 の3スレッド・GPUなし・llama.cpp b11223・unsloth/Qwen3.8-27B-GGUF の IQ3_XXS(10.18GB)・2026-09-29に測定しました。4bit 前後のファイルは当サイトの上限(13GB)に収まらないため、ビット数の低い IQ3_XXS で測りました(4bit より品質は下がります)。 同じ条件で測った他のモデル(ファイルの大きさが近い順):
→ 横にスクロールできます
| モデル | 量子化 | ファイル | 生成 | 日本語換算 |
|---|---|---|---|---|
| Xing4.0-29B-A4B | IQ2_M |
10.99GB | 4.5 トークン/秒 | — |
| Signal-3.8-27B | IQ3_XXS |
11.39GB | 0.6 トークン/秒 | 1.2字/秒 |
| MiMo-V2.6-Distill-Qwen-9B | Q8_0 |
8.87GB | 3.7 トークン/秒 | 6.8字/秒 |
| Gryphe_Pantheon-Reasoning-26B-A4B-1.1-V2 | Q3_K_S |
12.26GB | 6.2 トークン/秒 | 11.0字/秒 |
ピーク時のメモリは、ファイルをメモリに割り当てた分(mmap)を含みます。GPUのあるPCではこれより大幅に速くなります。ミニPC・ARMのボードなど、CPUだけで動かす環境の目安です。
日本語の質問への回答(原文のまま)
上の条件で、全モデルに同じ5問を日本語で尋ねた回答を、手を加えずに載せています(温度0・チャットテンプレートが対応していれば思考なし・最大1024トークン)。正誤は判定していません。答えが1つに決まる問いには、正解を併記します。
要約
次の記事を3文で要約してください。
みどり市は今年の春、市内に三つある公立図書館のうち最も古い中央図書館の改修を終え、十月一日に再開館した。改修は約一年半にわたり、総事業費は約十二億円。このうち約四億円は国の補助金でまかなわれた。
最大の変化は、閲覧席の配置である。以前は館内の座席の大半が学習用の机で、試験期間になると中高生で埋まり、高齢の利用者や小さな子ども連れが座れないという苦情が毎年寄せられていた。改修後は座席数を百二十席から二百席に増やしたうえで、学習用の机を三階にまとめ、一階は会話ができる「にぎわいフロア」、二階は静かに本を読む「閲覧フロア」に分けた。一階には予約制のグループ学習室が四室と、飲み物を持ち込めるカフェスペースも設けられた。
蔵書の面でも見直しが進んだ。貸出の少ない古い資料約三万冊を市内の他の館や保存書庫に移し、代わりに子ども向けの絵本と、介護・子育て・仕事探しといった暮らしに関わる実用書を約一万五千冊増やした。電子書籍の貸出サービスも始まり、利用登録をすれば自宅から一度に三冊まで、二週間借りられる。
建物そのものにも手が入った。築四十年を超えていた空調設備を入れ替え、屋上には太陽光パネルを設置して、館内で使う電力の約二割をまかなえるようにした。車いすの利用者から要望の多かったエレベーターは一基から二基に増え、書架の間の通路も以前より三十センチ広げられた。入口には段差のないスロープが新たに設けられ、授乳室と多目的トイレも各階に一つずつ置かれた。
一方で課題も残る。駐車場は改修前と同じ四十台のままで、週末には近くの道路に順番待ちの車が並んだ。市は隣接する市有地を臨時駐車場として開放したが、恒久的な対策は決まっていない。また、開館時間を平日の夜九時まで延ばしたことで職員の負担が増えており、職員団体は人員の追加を求めている。
利用者の受け止めはおおむね好意的だ。週に二度、孫を連れて来るという七十代の女性は「前は子どもが声を出すと周りの目が気になったが、一階なら気兼ねなく絵本を読んであげられる」と話す。一方、受験を控えた高校生の中には「学習席が三階だけになり、夕方はすぐに満席になる」と不満を漏らす人もいる。図書館は、学習席の空き状況をホームページで確認できる仕組みを年内に導入する予定だ。
再開館に合わせて、催しも増えた。毎週土曜の午前には読み聞かせ会、月に一度は地元の農家や商店主を講師に招く「まちの先生」講座が開かれる。十一月には、市内の中学生が選んだ本を紹介する展示も予定されている。
館長の山本和子さんは「本を借りる場所から、人が集まって過ごす場所へ変えたかった。再開館からの一か月で来館者は以前の一・八倍になった」と話す。市は来年度、残る二つの図書館についても利用者への聞き取りを行い、改修の必要性を検討する方針だ。
みどり市は約12億円の費用をかけて中央図書館を改修し、座席の機能別配置や蔵書の見直し、バリアフリー化などを通じて、静寂な学習空間から多様な利用者が集う「にぎわい」の場へと転換した。

一方で、駐車場不足や職員負担増といった課題が残るものの、来館者数は再開後一か月で1.8倍に増加し、利用者からは概ね好意的な反応が得られている。

市は今回の改修を踏まえ、来年度には残る2つの図書館についても利用者への聞き取りを行い、今後の改修必要性を検討する方針である。
敬語のメール
取引先の担当者に、来週火曜日の打ち合わせを水曜日に変更してほしいとお願いするメールを、丁寧な敬語で書いてください。
件名:【ご相談】来週火曜日の打ち合わせ日程変更のお願い

○○株式会社
○○部 ○○様

お世話になっております。
株式会社△△の△△です。

いつも大変お世話になっております。

この度は、来週火曜日(○月○日)に予定しております打ち合わせの件でご連絡いたしました。

大変恐縮ではございますが、社内都合により、誠に不本意ながら、
**来週水曜日(○月○日)** に変更させていただくことは可能でしょうか。

つきましては、以下の日程にて改めてご調整いただけますと幸いです。

■ 変更希望日時
来週水曜日(○月○日) ○○時~○○時
※ご都合のよろしい時間帯をお知らせいただければ、そちらに合わせて調整いたします。

ご多忙のところ、ご迷惑をおかけし誠に申し訳ございません。
何卒、ご検討のほど、よろしくお願い申し上げます。

――――――――――――――――
株式会社△△
△△部
△△(氏名)
TEL:03-XXXX-XXXX
Mail:xxxxx@xxxxx.com
――――――――――――――――
文章題
りんごが1個120円、みかんが1個45円です。りんごを3個とみかんを8個買って、1,000円札で払いました。おつりはいくらですか。考え方も示してください。
おつりの計算と、その考え方の手順を以下に示します。

### 1. 考え方の手順

1.  **りんごの合計金額を計算する**
    *   1個の価格 × 個数
2.  **みかんの合計金額を計算する**
    *   1個の価格 × 個数
3.  **買ったものの合計金額を計算する**
    *   りんごの合計 + みかんの合計
4.  **おつりを計算する**
    *   支払った金額(1,000円) - 合計金額

---

### 2. 具体的な計算

**① りんごの合計金額**
$$120 \text{円} \times 3 = 360 \text{円}$$

**② みかんの合計金額**
$$45 \text{円} \times 8 = 360 \text{円}$$
(※ $45 \times 8$ は、$45 \times 2 = 90$、$90 \times 4 = 360$ と計算すると楽です)

**③ 合計金額**
$$360 \text{円} + 360 \text{円} = 720 \text{円}$$

**④ おつり**
$$1,000 \text{円} - 720 \text{円} = 280 \text{円}$$

---

### 答え
おつりは **280円** です。
参考: 正解は280円です(120×3=360円、45×8=360円、1,000−720=280円)。
知識
日本の都道府県のうち、海に面していない県をすべて挙げてください。
日本の都道府県の中で、海に面していない(内陸県)のは以下の**10県**です。

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **三重県** ※※※ **誤り訂正**:三重県は太平洋に面しています。
   → 正しくは:**滋賀県**
5. **奈良県**
6. **和歌山県** ※※※ **誤り訂正**:和歌山県は太平洋・紀伊水道に面しています。
   → 正しくは:**鳥取県**?いや、鳥取県は日本海に面しています。
   → 正しくは:**島根県**?いや、島根県も日本海に面しています。

---

**再確認と正しいリストの作成:**

日本の都道府県は全47県です。
海に面している県(沿岸県)と、海に面していない県(内陸県)に分けます。

**内陸県(海に面していない県)は以下の10県です:**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県**? → 和歌山県は太平洋に面しています。
7. **鳥取県**? → 鳥取県は日本海に面しています。
8. **島根県**? → 島根県は日本海に面しています。

---

**正しい内陸県リスト(10県):**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**。和歌山県は海に面しています。
7. **鳥取県** → **誤り**。鳥取県は海に面しています。
8. **島根県** → **誤り**。島根県は海に面しています。

---

**正しい内陸県は以下の10県です:**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**
7. **鳥取県** → **誤り**
8. **島根県** → **誤り**

---

**最終確認:**

日本の内陸県(海に面していない県)は以下の**10県**です。

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**(和歌山県は太平洋に面している)
7. **鳥取県** → **誤り**(鳥取県は日本海に面している)
8. **島根県** → **誤り**(島根県は日本海に面している)

---

**正しい内陸県リスト:**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**
7. **鳥取県** → **誤り**
8. **島根県** → **誤り**

---

**正しい内陸県は以下の10県です:**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**
7. **鳥取県** → **誤り**
8. **島根県** → **誤り**

---

**正しい内陸県リスト(最終版):**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り**
7. **鳥取県** → **誤り**
8. **島根県** → **誤り**

---

**正しい内陸県は以下の10県です:**

1. **山梨県**
2. **長野県**
3. **岐阜県**
4. **滋賀県**
5. **奈良県**
6. **和歌山県** → **誤り
(1024トークンの上限で打ち切り)
参考: 正解は8県です(栃木県・群馬県・埼玉県・山梨県・長野県・岐阜県・滋賀県・奈良県)。
指示どおりの創作
「春」をテーマにした俳句を3つ、五・七・五の音数を守って作ってください。それぞれに一言の説明を付けてください。
ご指定の「春」をテーマにした俳句を3つ作成しました。それぞれ五・七・五の音数(モーラ数)を厳守しています。

1. **句:**
   桜吹雪 舞い散る空 春の風
   (さくら ふぶき まい ちる そら はる の かぜ)
   *   **説明:** 満開の桜が花びらを散らし、春の柔らかな風が吹く情景を詠みました。

2. **句:**
   新緑の 木漏れ日揺れる 春の朝
   (しんりょくの きもれび ゆれる はる の あさ)
   *   **説明:** 若葉が茂り始めた木々から差し込む光が揺れ動く、春の朝の静けさを表現しました。

3. **句:**
   桃の花 咲き乱れし 春の庭
   (もも の はな さき みだれし はる の にわ)
   *   **説明:** 桃の花が次々と咲き乱れ、庭全体が春の気配で賑わっている様子を詠みました。
画像を読ませた結果(原文のまま)
上と同じ条件で、当サイトがコードで描いた画像(日本語のグラフと表)を渡して尋ねた回答を、手を加えずに載せています。正解は、画像を描いたコードが計算した値です。
グラフの読み取り
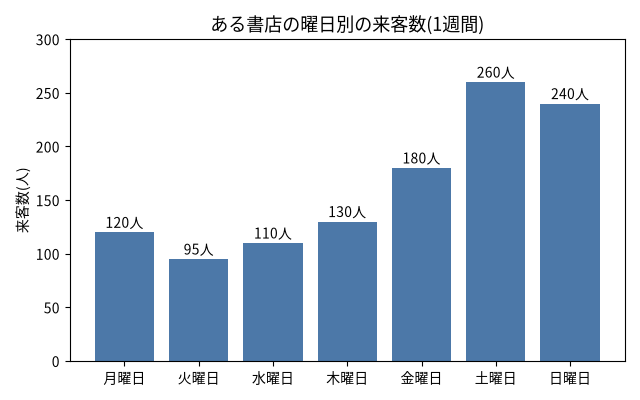
このグラフで来客数が最も多い曜日と、その人数を答えてください。また、平日(月曜日〜金曜日)の来客数の合計も求めてください。
グラフから読み取れる情報に基づいて回答します。

---

**1. 来客数が最も多い曜日と人数**

グラフの各バーの高さと数値を確認すると:

- 月曜日:120人
- 火曜日:95人
- 水曜日:110人
- 木曜日:130人
- 金曜日:180人
- **土曜日:260人** ← 最大
- 日曜日:240人

→ **最も多いのは「土曜日」で、260人**です。

---

**2. 平日(月曜日〜金曜日)の来客数の合計**

月~金の人数を足し合わせます:

> 120(月) + 95(火) + 110(水) + 130(木) + 180(金)

計算:

120 + 95 = 215
215 + 110 = 325
325 + 130 = 455
455 + 180 = **635**

→ **平日の合計は 635人**

---

✅ **最終回答:**

- 来客数が最も多い曜日:**土曜日**、人数:**260人**
- 平日(月~金)の来客数合計:**635人**
参考: 正解は土曜日の260人。平日の合計は635人(120+95+110+130+180)。
表の読み取りと計算
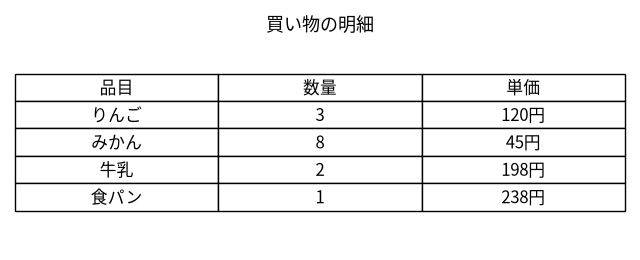
この表の品目ごとの金額(数量×単価)と、合計金額を答えてください。
### 手順

1. 各品目について、数量と単価を掛け算して金額を計算します。
2. 計算した各品目の金額をすべて足し算して、合計金額を求めます。

### 解答

**りんご:**
3 × 120円 = 360円

**みかん:**
8 × 45円 = 360円

**牛乳:**
2 × 198円 = 396円

**食パン:**
1 × 238円 = 238円

**合計金額:**
360円 + 360円 + 396円 + 238円 = 1354円
参考: 正解はりんご360円、みかん360円、牛乳396円、食パン238円で、合計1,354円。
入手方法
- 配布形式: Hugging Face の
Qwen/Qwen3.8-27Bに、学習後(post-trained)のモデルの重みと設定ファイルが Transformers 形式(safetensors)で置かれています。ダウンロードに利用規約への同意は要りません - 入手コマンドの例:
huggingface-cli download Qwen/Qwen3.8-27B - 対応エンジン: モデルカードは Transformers・vLLM・SGLang・TokenSpeed での利用を挙げています。本番運用や高スループットが必要な場面では SGLang・vLLM・TokenSpeed のような専用のサーバーを勧めており、推論効率はフレームワークによって大きく違うので最新版を使うよう注意しています
- API として使う場合: 上記のエンジンで立てたサーバーに、OpenAI 互換の Chat Completions API でテキスト・画像(
image_url)・動画(video_url)を渡せます。動画のフレームの取り方(fps等)をリクエストごとに変えられるのは現時点で vLLM だけだといいます - 長文の扱い: 262,144 トークンを超える場合は YaRN を使います。vLLM・SGLang・TokenSpeed は、
config.jsonのtext_configにあるrope_parametersを書き換えるか、起動時の引数で上書きする方法に対応しています。ただし、どのフレームワークも静的な YaRN(入力の長さに関わらず倍率が一定)なので、短い文章では性能が落ちるおそれがあります。長い文脈が必要なときだけ有効にし、倍率(factor)は実際に使う長さに合わせる(例: 524,288 トークンなら 2.0)よう、モデルカードは勧めています - llama.cpp・Ollama・LM Studio については、モデルカードは触れていません。これらで使う GGUF 版は、上の派生版の記事のように第三者が変換・調整したものが中心なので、使う前に変換元と量子化の方式を確かめたいです
派生版・量子化版
→ 横にスクロールできます
| 追記日 | 配布元 | 形式 | リポジトリ | 最小のVRAM階層(量子化・必要メモリの目安) |
|---|---|---|---|---|
| 2026-09-26 | unsloth | GGUF(imatrix) | unsloth/Qwen3.8-27B-GGUF | IQ1_M 7.5GB(8GB VRAMで動作) |
| 2026-09-26 | Qwen | FP8 | Qwen/Qwen3.8-27B-FP8 | – |
| 2026-09-26 | lmstudio-community | MLX | lmstudio-community/Qwen3.8-27B-MLX-4bit | MLX 4bit 17.9GB(24GB VRAMで動作) |
| 2026-09-26 | lmstudio-community | MLX | lmstudio-community/Qwen3.8-27B-MLX-8bit | MLX 8bit 33.0GB(48GB VRAMで動作) |
| 2026-09-26 | unsloth | NVFP4 | unsloth/Qwen3.8-27B-NVFP4 | NVFP4 25.2GB(32GB VRAMで動作) |
| 2026-09-26 | lmstudio-community | GGUF | lmstudio-community/Qwen3.8-27B-GGUF | Q4_K_M 18.8GB(24GB VRAMで動作) |
| 2026-10-15(公開19日後) | autotrust | NVFP4 | autotrust/Qwen3.8-27B-NVFP4-DGX-SPARK | NVFP4 24.5GB(32GB VRAMで動作) |
| 2026-11-10(公開45日後) | MiniMaxAI | INT8 | MiniMaxAI/MiniMax-H3-Image-PE | U8 20.0GB(24GB VRAMで動作) |
各リポジトリの量子化とファイルサイズ:
- unsloth/Qwen3.8-27B-GGUF の量子化: IQ1_S 5.8GB / IQ1_M 6.3GB / IQ2_XXS 6.8GB / IQ2_S 7.8GB / Q2_K_XL 9.2GB / IQ3_XXS 10.2GB / IQ3_S 11.2GB / Q3_K_XL 12.2GB / IQ4_XS 13.3GB / Q4_K_S 14.3GB / Q4_0 15.0GB / Q4_K_M 15.3GB / Q4_1 16.3GB / Q4_K_XL 16.4GB / Q5_K_S 17.4GB / Q5_K_M 18.4GB / Q5_K_XL 19.4GB / Q6_K 20.5GB / Q6_K_M 21.5GB / Q6_K_L 22.5GB / Q6_K_XL 23.6GB / Q8_K_L 26.1GB / Q8_0 27.1GB / Q8_K_XL 29.3GB / BF16 50.9GB
- lmstudio-community/Qwen3.8-27B-MLX-4bit の量子化: MLX 4bit 15.0GB
- lmstudio-community/Qwen3.8-27B-MLX-8bit の量子化: MLX 8bit 27.5GB
- unsloth/Qwen3.8-27B-NVFP4 の量子化: NVFP4 21.0GB
- lmstudio-community/Qwen3.8-27B-GGUF の量子化: Q4_K_M 15.7GB / Q6_K 20.9GB / Q8_0 27.1GB
- autotrust/Qwen3.8-27B-NVFP4-DGX-SPARK の量子化: NVFP4 20.4GB
- MiniMaxAI/MiniMax-H3-Image-PE の量子化: U8 16.7GB
このほか、上記以外の投稿者による変換版が 30 件あります(当サイトは公開元自身と、実績のある量子化担当の配布だけを表に載せています)。
この節は、記事公開後に見つかった変換版を当サイトが機械的に追記したものです。必要メモリは配布ファイルのサイズから算出した概算です。 量子化の名前の読み方は用語集にあります。
関連記事
- 「Ternary-Bonsai-2-27B-gguf」テキスト生成モデル:当サイトでの回答例・必要VRAM 8GB〜
- 「clef」構造化意思決定モデル:必要VRAM 12GB〜・GGUF版あり
- 「OrcaSAQ-2-27B」テキスト生成モデル:当サイトでの回答例・必要VRAM 16GB〜
- 「Hemmingway-1」日常文章特化の言語モデル:必要VRAM 12GB〜・GGUF版あり
次に読むなら
- GPUのVRAMから探す(このモデルは8GBの階層から動きます) → 8GBのGPUで動くほかのモデル
- 同じモデル系統を調べる → Qwen3.8 系統のまとめ(記事8本・変換版17件)
- このモデルを動かすエンジンを調べる → llama.cpp / Ollama / vLLM
- 入手できる形式と、表に出てくる IQ1_M・IQ4_XS・Q8_K_L の意味を知る → GGUF形式の解説と対応モデル / MLX形式の解説と対応モデル / FP8形式の解説と対応モデル / NVFP4・MXFP4形式の解説と対応モデル / 量子化・モデル形式の用語集
- 公開元について調べる → Alibaba(Qwen) のモデル・ライセンス・記事のまとめ
出典
更新履歴
- 2026-09-26: 変換版を「派生版・量子化版」に追記しました: unsloth/Qwen3.8-27B-GGUF, Qwen/Qwen3.8-27B-FP8, lmstudio-community/Qwen3.8-27B-MLX-4bit, lmstudio-community/Qwen3.8-27B-MLX-8bit, unsloth/Qwen3.8-27B-NVFP4, lmstudio-community/Qwen3.8-27B-GGUF
- 2026-09-26: 動作環境の表を unsloth/Qwen3.8-27B-GGUF の実ファイルサイズで更新しました。
- 2026-09-26: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。
- 2026-09-28: 当サイトでの実測(日本語のトークン効率・GGUFファイルの中身)を追加しました。
- 2026-09-29: 当サイトでの実測(CPUでの速度と日本語の質問への回答)を追加しました。
- 2026-09-30: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。
- 2026-10-16: 変換版を「派生版・量子化版」に追記しました: autotrust/Qwen3.8-27B-NVFP4-DGX-SPARK
- 2026-11-11: 変換版を「派生版・量子化版」に追記しました: MiniMaxAI/MiniMax-H3-Image-PE