「Supra2-IMG」軽量なテキストから画像への生成モデル:当サイトの生成画像・配布ファイル一覧
作例は配布元のモデルカードで公開されています。
基本情報
| 項目 | 内容 |
|---|---|
| リポジトリ | SupraLabs/Supra2-IMG |
| 公開日 | 2026-09-21 |
| ライセンス | apache-2.0 |
| 出典の種類 | 公開元の一次情報(HuggingFace公式リポジトリが一次情報) |
情報を集めた時点で、当サイトのコードが確定させた値です。日付はJSTで表示しています。
当サイトで確かめたこと
- 当サイトのサーバーで生成した画像を、選別・加工せずに載せています。
詳しい値と条件は、下の「当サイトでの実測」の節にあります。
概要
SupraLabsは、高品質な合成データセットを用いてスクラッチから学習された、極めて軽量なテキストから画像への生成モデル(Text-to-Image)である「Supra2-IMG」を公開しました。このモデルは、パラメータ数が約100M(1億)という非常に小さなサイズでありながら、その規模においてState-of-the-art(SOTA)の画像品質を提供することを目的として設計されています。
スペック
モデルの主要な仕様および構成は以下の通りです。
- アーキテクチャ: Diffusion Transformer (DiT) / SupraDiT
- パラメータ数: 104.1M
- 入力: テキスト
- 出力解像度: 256²
- 潜在変数サイズ (Latent size): 32²
- パッチサイズ: 2
- テキストエンコーダー: Flan-T5-Base (frozen)
- VAE: SD-VAE-FT-MSE
- 推奨サンプリング設定:
- CFGスケール: 3.0 – ステップ数: 50 – シード値: 0
- モデル構成の詳細:
D_MODEL: 576 –DEPTH: 14 –N_HEADS: 9 –HEAD_DIM: 64 –MLP_RATIO: 4.0 –D_CTX: 768 –VAE_SCALE: 0.18215
- ライセンス: apache-2.0
性能・品質
Supra2-IMGは、5.6M(560万)枚の画像を含む「LucasFang/FLUX-Reason-6M」データセットを用いて、10エポックの学習が行われました。データ準備のプロセスにおいては、学習に用いるデータの品質を最大限に高めるため、プロンプトの選択において特定の優先順位が設けられています。具体的には、caption_composition、caption_entity、caption_text、caption_style、caption_imaginativeという順序でプロンプトが選択され、前のプロンプトが利用できない場合のフォールバックとして機能することで、最も高品質なデータのみがプリトレーニングに使用されるよう厳格に管理されています。
学習環境については、単一のNvidia H100 SXM 80GB(Runpod Pod)を使用し、データ準備の時間を含めて合計9時間で完了したと報告されています。また、学習には2.5TBのディスクが使用されました。
モデルカードによれば、この104.1Mという極めて小さなパラメータ数において、SOTA(State-of-the-art)の品質を実現しているとされています。具体的な数値によるベンチマーク比較は示されていませんが、高品質な合成データと効率的なDiTアーキテクチャの組み合わせにより、モデルサイズに対する高い生成能力を持っていることが強調されています。
得意なこと・想定用途
Supra2-IMGは、テキストから画像を生成するText-to-Image(T2I)モデルであり、その最大の特徴は、わずか104.1Mという極めて小さなパラメータ数で、モデルサイズに対してSOTA(State-of-the-art)級の品質を実現している点にあります。これは、学習プロセスにおいて「LucasFang/FLUX-Reason-6M」という5.6M枚の画像を含む高品質な合成データセットを、非常に厳格な基準で準備したことが大きく寄与しています。
具体的には、データの準備段階において、caption_composition、caption_entity、caption_text、caption_style、caption_imaginative という順序でプロンプトの質を評価し、前の段階の品質が満たされない場合にのみ次のプロンプトを使用するというフォールバック方式が採用されています。このプロセスにより、モデルは最も高品質なデータのみを学習対象としており、結果として、限られた計算リソースやメモリ容量でも、精度の高い画像生成を行うことが期待されます。
現在は、英語(en)を対象とした生成を想定しており、将来的に「Supra2.5-IMG」のような次世代モデルへと進化させる計画も示されています。軽量ながらも高品質な生成を求める、ローカル環境での動作を重視する技術者にとって、非常に有力な選択肢となるでしょう。
配布ファイル
SupraLabs/Supra2-IMG で配布されている重みファイルを、Hugging FaceのAPIから当サイトが並べたものです。サイズは実ファイルの値です。
| ファイル | サイズ |
|---|---|
model_final_ema.pt |
417MB |
入手方法
モデルの利用は、Hugging Faceのリポジトリから提供される推論用スクリプトを用いて行います。配布形式は、スクリプトとモデルの重みファイル(model_final_ema.pt)を組み合わせて使用する形となります。
まず、以下のコマンドを実行して作業用のディレクトリを作成し、推論スクリプト inference.py を取得してください。
# プロジェクトディレクトリの作成
mkdir Supra2-IMG
cd Supra2-IMG

# 推論スクリプトのダウンロード
wget https://huggingface.co/SupraLabs/Supra2-IMG/resolve/main/inference.py
次に、python inference.py コマンドを使用して画像生成を開始できます。実行時には、生成したい内容を記述する --prompt 引数に加え、再現性を確保するための --seed、生成の品質を制御する --cfg(推奨値は3.0)、およびサンプリングの精度を決定する --steps(推奨値は50)などのオプションを指定します。また、生成する枚数を示す --n や、出力ファイル名を指定する --out も利用可能です。
python inference.py --prompt "a sea jellyfish floating in the pitch-black ocean depths" --seed 0 --cfg 3.0 --steps 50 --n 1 --out jellyfish.png
実行時のログには、使用されるデバイス、ロードされたチェックポイント、モデルのパラメータ数、テキストエンコーダー(Flan-T5-Base)のロード状況、およびサンプリング工程(Euler flow)の詳細が表示されます。
なお、本モデルのダウンロードにあたって、Hugging Face上でのライセンス同意(Gated access)は必要ありません。
手元で動かせるか
ライセンス apache-2.0(商用利用可): 商用利用を含めて自由に利用・改変・再配布できます。再配布時にライセンス文と変更点の告知が必要で、特許の許諾条項があります。
配布形式とライセンス表記から当サイトのコードが組み立てた判定です。ライセンスの要約は法的助言ではないため、実際の利用にあたっては公開元の原文を確認してください。
当サイトでの実測
当サイトのサーバー(GPUなし)で、このモデルのファイルを実際に読み込み・動かして確かめた値です。モデルカードの記載ではなく、当サイトが測った結果です。測り方と全モデルの一覧は観測データにまとめています。
当サイトで生成した画像
GPU の無い当サイトのサーバー(Neoverse-N1 の3スレッド)で、SupraLabs/Supra2-IMG(apache-2.0 ライセンス)を配布元の推論コード(Supra2-IMG inference.py のコミット 10dec6e)で動かし、生成中はネットワークから切り離した環境で生成しました。256×256ピクセル・50ステップ・ガイダンススケール 3.0・シード 0・人物・ロゴ・文字を含まない固定のプロンプト・2026-09-30生成。加工や選別はしておらず、プロンプトごとに1枚目をそのまま載せています。
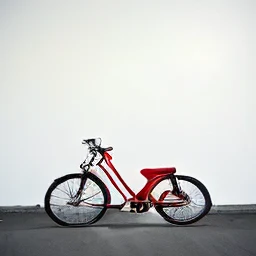
プロンプト: 「a red bicycle leaning against a white wall on a quiet street, soft morning light, photograph」(生成に46.0秒。日本語訳: 静かな通りの白い壁に立てかけられた赤い自転車、柔らかな朝の光、写真)
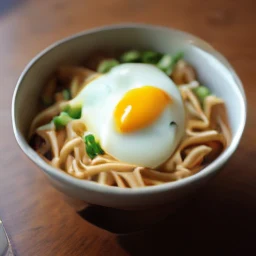
プロンプト: 「a bowl of ramen with a soft-boiled egg and green onions on a wooden table, top view, photograph」(生成に46.0秒。日本語訳: 木のテーブルに置かれた半熟卵とねぎのラーメン、真上から、写真)
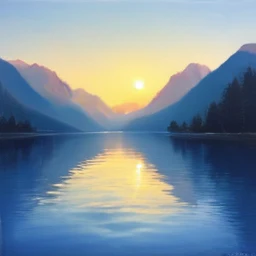
プロンプト: 「a mountain lake at sunset with the mountains reflected in calm water, oil painting」(生成に46.0秒。日本語訳: 夕暮れの山の湖、静かな水面に山が映る、油絵)
環境構築と実行の手順(当サイトで実行したもの)
以下は当サイトのサーバー(Linux aarch64・Python 3.12.3)で、1つの作業フォルダから実際に実行したコマンドです。当サイトでは配布元のコードを隔離した環境で動かしているため、1と2はネットワークあり、3はネットワークなしで行っています。1の実行環境は一度作ったものを使い回しています。
# 1. 実行環境を作る(CPU 版の PyTorch と依存を入れる)
python3 -m venv venv
venv/bin/pip install --index-url https://download.pytorch.org/whl/cpu -c constraints.txt torch
venv/bin/pip install -c constraints.txt transformers diffusers safetensors huggingface-hub sentencepiece pillow numpy tqdm

# 2. 配布元のコードと重みを取得する(版を固定)
venv/bin/hf download SupraLabs/Supra2-IMG --revision 10dec6e4b4b5d1c44fd1d7d3fe5e50137333da5b --include inference.py --include model_final_ema.pt
venv/bin/hf download google/flan-t5-base --revision 7bcac572ce56db69c1ea7c8af255c5d7c9672fc2 --include config.json --include generation_config.json --include model.safetensors --include special_tokens_map.json --include spiece.model --include tokenizer.json --include tokenizer_config.json
venv/bin/hf download stabilityai/sd-vae-ft-mse --revision 31f26fdeee1355a5c34592e401dd41e45d25a493 --include config.json --include diffusion_pytorch_model.safetensors

# 3. 生成する
venv/bin/python supra2_img.py job.json out
constraints.txt は依存の版の一覧で、当サイトの実行環境で pip freeze した結果です(全文は下に)。NVIDIA の GPU がある環境では、最初の pip install の --index-url を、お使いの CUDA の版に合った PyTorch の配布先に置き換えてください。
生成に使ったスクリプト(supra2_img.py、当サイトが書いたもの。配布元の推論コード inference.py: SupraDiT を呼んでいます):
"""
Supra2-IMG で、固定のプロンプトから画像を作る(Local Model Watch の実測。記事にこのファイルの全文を載せている)。

    python supra2_img.py <job.json> <出力フォルダ>

配布元の inference.py から SupraDiT(モデルの定義)だけを読み込み、サンプリング(Euler 法・CFG)は
配布元と同じ手順をここに書き直している。重みは先に hf download で同じ版を取っておく(当サイトでは
このスクリプトをネットワークの無い環境で動かすので、ここでは取りに行かない)。重みは weights_only で読む。
出力は <id>.png と result.json(生成にかかった秒数など)。
"""
import importlib.util
import json
import os
import sys
import time

def main() -> int:
    with open(sys.argv[1], encoding="utf-8") as f:
        job = json.load(f)
    out_dir = sys.argv[2]
    os.makedirs(out_dir, exist_ok=True)
    import numpy as np
    import torch
    from diffusers import AutoencoderKL
    from huggingface_hub import hf_hub_download
    from PIL import Image
    from transformers import AutoTokenizer, T5EncoderModel

    torch.set_num_threads(int(job["threads"]))
    run = job["runs"][0]
    model = run["model"]
    extra = {d["repo"]: d for d in job["downloads"]}
    t5 = extra["google/flan-t5-base"]
    vae_repo = extra["stabilityai/sd-vae-ft-mse"]

    spec = importlib.util.spec_from_file_location(
        "supra_inference", hf_hub_download(model["repo"], "inference.py", revision=model["revision"]))
    supra = importlib.util.module_from_spec(spec)
    spec.loader.exec_module(supra)

    started = time.time()
    net = supra.SupraDiT().eval()
    state = torch.load(hf_hub_download(model["repo"], "model_final_ema.pt", revision=model["revision"]),
                       map_location="cpu", weights_only=True)
    cfg_state = state.get("config", {}) if isinstance(state, dict) else {}
    weights = state["ema"] if "ema" in state else state.get("model", state)
    net.load_state_dict(weights, strict=True)
    ctx_len = int(cfg_state.get("ctx_len", supra.MAX_CTX_LEN))
    tokenizer = AutoTokenizer.from_pretrained(t5["repo"], revision=t5["revision"])
    text_model = T5EncoderModel.from_pretrained(t5["repo"], revision=t5["revision"]).eval()
    vae = AutoencoderKL.from_pretrained(vae_repo["repo"], revision=vae_repo["revision"]).eval()
    load_sec = round(time.time() - started, 1)

    steps = int(job["steps"])
    cfg = float(job["cfg"])
    items = []
    with torch.no_grad():
        for item in run["items"]:
            t = time.time()
            tok = tokenizer([item["prompt"]], padding="max_length", truncation=True, max_length=ctx_len,
                            return_tensors="pt")
            ctx = text_model(**tok).last_hidden_state.float()
            mask = tok["attention_mask"].float()
            if "uncond_text" in cfg_state:
                u_ctx = cfg_state["uncond_text"].float().unsqueeze(0)
                u_mask = cfg_state["uncond_mask"].float().unsqueeze(0)
            else:
                u_tok = tokenizer([""], padding="max_length", truncation=True, max_length=ctx_len,
                                  return_tensors="pt")
                u_ctx = text_model(**u_tok).last_hidden_state.float()
                u_mask = u_tok["attention_mask"].float()
            ctx_all, mask_all = torch.cat([ctx, u_ctx], 0), torch.cat([mask, u_mask], 0)
            torch.manual_seed(int(job["seed"]))
            z = torch.randn(1, supra.LATENT_CH, supra.LATENT_SIZE, supra.LATENT_SIZE)
            dt = 1.0 / steps
            for i in range(steps):
                tt = torch.full((1,), i * dt)
                v_cond, v_uncond = net(torch.cat([z, z], 0), torch.cat([tt, tt], 0), ctx_all, mask_all).float().chunk(2, 0)
                z = z + dt * (v_uncond + cfg * (v_cond - v_uncond))
            image = vae.decode(z / supra.VAE_SCALE).sample
            image = ((image.clamp(-1, 1) + 1) / 2 * 255).round().to(torch.uint8)[0].permute(1, 2, 0).numpy()
            Image.fromarray(np.ascontiguousarray(image)).save(os.path.join(out_dir, item["id"] + ".png"))
            items.append({"id": item["id"], "seconds": round(time.time() - t)})
            print(f"[generate] {item['id']}: {items[-1]['seconds']} s", flush=True)
    with open(os.path.join(out_dir, "result.json"), "w", encoding="utf-8") as f:
        json.dump({"items": items, "load_sec": load_sec, "torch": torch.__version__}, f)
    return 0

if __name__ == "__main__":
    sys.exit(main())
スクリプトが読む job.json の項目(実際に使った値):
{
  "runs": [
    {
      "model": {
        "repo": "SupraLabs/Supra2-IMG",
        "revision": "10dec6e4b4b5d1c44fd1d7d3fe5e50137333da5b"
      },
      "items": [
        {
          "id": "bicycle",
          "prompt": "a red bicycle leaning against a white wall on a quiet street, soft morning light, photograph"
        },
        {
          "id": "ramen",
          "prompt": "a bowl of ramen with a soft-boiled egg and green onions on a wooden table, top view, photograph"
        },
        {
          "id": "lake",
          "prompt": "a mountain lake at sunset with the mountains reflected in calm water, oil painting"
        }
      ]
    }
  ],
  "downloads": [
    {
      "repo": "SupraLabs/Supra2-IMG",
      "revision": "10dec6e4b4b5d1c44fd1d7d3fe5e50137333da5b",
      "files": [
        "inference.py",
        "model_final_ema.pt"
      ]
    },
    {
      "repo": "google/flan-t5-base",
      "revision": "7bcac572ce56db69c1ea7c8af255c5d7c9672fc2",
      "files": [
        "config.json",
        "generation_config.json",
        "model.safetensors",
        "special_tokens_map.json",
        "spiece.model",
        "tokenizer.json",
        "tokenizer_config.json"
      ]
    },
    {
      "repo": "stabilityai/sd-vae-ft-mse",
      "revision": "31f26fdeee1355a5c34592e401dd41e45d25a493",
      "files": [
        "config.json",
        "diffusion_pytorch_model.safetensors"
      ]
    }
  ],
  "seed": 0,
  "steps": 50,
  "cfg": 3.0,
  "threads": 3
}
constraints.txt(全文)
annotated-doc==0.0.5 anyio==4.15.1 certifi==2026.7.22 charset-normalizer==3.5.1 click==8.5.0 diffusers==0.40.0 filelock==3.32.3 fsspec==2026.7.0 h11==0.16.0 hf-xet==1.6.0 httpcore==1.0.9 httpx==0.28.1 huggingface_hub==1.33.0 idna==3.20 importlib_metadata==9.0.1 Jinja2==3.1.6 markdown-it-py==4.2.0 MarkupSafe==3.0.3 mdurl==0.1.2 mpmath==1.3.0 networkx==3.6.1 numpy==2.5.3 packaging==26.3 pillow==12.3.0 Pygments==2.21.0 PyYAML==6.0.3 regex==2026.9.29 requests==2.34.2 rich==15.0.0 safetensors==0.8.0 sentencepiece==0.2.2 setuptools==78.1.0 shellingham==1.5.4 sympy==1.14.0 tokenizers==0.23.2 torch==2.14.0+cpu tqdm==4.70.1 transformers==5.17.0 typer==0.27.2 typing_extensions==4.16.0 urllib3==2.8.0 zipp==4.1.0同じ用途の既報モデル
当サイトが取り上げた画像生成・編集のモデルを新しい順に並べています。用途は配布元がHugging Faceに付けたタスク(pipeline_tag)から機械的に分けたもので、最小のVRAM階層は当サイトの概算です。
- 「QI_2.1_AnyAngle」カメラアングル操作LoRA:必要VRAM 48GB〜・配布ファイル一覧(7.1B)
- 「Qwen-Image-2.1-viggle-turbo」4ステップの高速画像生成・編集モデル:必要VRAM 48GB〜(7.1B)
- 画像生成・編集モデル「Qwen-Image-2.1」公開、透過処理や高度なマルチ画像編集に対応
出典
更新履歴
- 2026-09-24: 記事の組み立てを更新しました: 「手元で動かせるか」の判定(配布形式・変換版・推論エンジンの登録表・ライセンス・実測の圧縮率)を追加
- 2026-09-25: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。
- 2026-09-30: 当サイトでの実測(当サイトで生成した画像)を追加しました。
- 2026-09-30: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。