「clef-flash」構造化出力特化型モデル:当サイトでの回答例・必要VRAM 4GB〜・GGUF版あり
基本情報
| 項目 | 内容 |
|---|---|
| リポジトリ | Cloudflare/clef-flash |
| まとめページ | Qwen3.5 のまとめ(記事8本) |
| 公開元のまとめ | Alibaba(Qwen) のモデルとライセンスのまとめ |
| 公開日 | 2026-10-01 |
| ライセンス | apache-2.0 |
| 配布形式 | safetensors |
| 出典の種類 | 公開元の一次情報(Cloudflare公式HFリポジトリ) |
情報を集めた時点で、当サイトのコードが確定させた値です。日付はJSTで表示しています。
当サイトで確かめたこと
- GPU の無い当サイトのサーバー(Neoverse-N1・3スレッド・llama.cpp b11347)で
Cloudflare_clef-flash-Q4_K_M.gguf(Q4_K_M)を動かし、生成は 3.9 トークン/秒でした(CPU での値で、GPU の速さの目安ではありません)。 - 固定の日本語の質問への回答を、下に原文のまま載せています。
- 全ての意思決定モデルに出している当サイトの判定問題20問を、配布元のコードをクラウドの GPU(NVIDIA L4・ネットワーク遮断)で動かして解かせ、日本語で18問・英語で18問正解しました。
- Qwen3 のトークナイザより約21%少ないトークンで同じ日本語を表せます。同じ文脈長に入る日本語が約1.26倍になり、生成も1字あたりで速くなります。
詳しい値と条件は、下の「当サイトでの実測」の節にあります。
スペック
- パラメータ数:9B
- アーキテクチャ:Qwen3.5-9B(Gated DeltaNet + 混合専門家モデル:MoE)およびビジョンエンコーダ、独自のJoint schema head
- コンテキスト長:ネイティブ 262,144トークン(YaRN等の手法により最大 1,010,000トークンまで拡張可能)
性能
公開元が実施した「Decision Index 0.2.1」スイートによる内部測定結果を以下に示します。比較対象として、上位モデルのClef、およびJev、Kev 9Bの数値を抜粋して掲載します。
Decision Index 測定結果
→ 横にスクロールできます
| Benchmark | Clef | Clef-flash | Jev | Kev 9B |
|---|---|---|---|---|
| BFCL (case exact accuracy) | 98.5 | 98.8 | 95.8 | 94.5 |
| ToolRet (nDCG@10) | 69.2 | 66.4 | 65.3 | 64.3 |
| API-Bank (accuracy) | 91.9 | 93.1 | 88.2 | 56.3 |
| BANKING77 (macro-F1) | 94.2 | 90.9 | 79.7 | 84.8 |
| CLINC150+OOS (macro-F1) | 97.4 | 66.8 | 89.3 | 79.0 |
| RouterBench (selected quality) | 79.7 | 79.9 | 79.9 | 80.0 |
| Home appliance simulator (case exact accuracy) | 83.0 | 97.7 | 52.3 | 25.0 |
| SGD/SGD-X (macro-F1) | 43.8 | 34.2 | 43.0 | 64.0 |
| ContractNLI (macro-F1) | 81.4 | 84.3 | 71.7 | 57.8 |
| ANLI (macro-F1) | 69.8 | 59.1 | 74.8 | 56.3 |
| BPoMP (accuracy) | 96.9 | 95.4 | 90.6 | 67.0 |
| Humicroedit (accuracy) | 66.7 | 75.1 | 61.9 | 55.8 |
| POP909-CL (accuracy) | 15.8 | 1.6 | 18.1 | 10.8 |
| cfcolor (accuracy) | 66.0 | 65.8 | 64.7 | 56.3 |
| MMLU (accuracy) | 90.3 | 91.8 | 91.7 | 75.3 |
| GPQA Diamond (accuracy) | 48.0 | 51.0 | 78.3 | 38.8 |
| ARC-Easy (accuracy) | 99.0 | 99.5 | 99.3 | 97.7 |
| ARC-Challenge (accuracy) | 97.7 | 98.3 | 97.8 | 93.7 |
| WinoGrande (accuracy) | 93.5 | 97.5 | 92.0 | 73.2 |
| HellaSwag (accuracy) | 98.2 | 98.6 | 94.5 | 81.9 |
| GSM8K (accuracy) | 80.8 | 67.3 | 79.9 | 48.7 |
| ChessBench (accuracy) | 24.7 | 23.0 | 17.2 | 11.2 |
| MuSR (accuracy) | 83.5 | 86.0 | 66.1 | 57.9 |
| SATA-Bench (case exact accuracy) | 33.8 | 36.7 | 26.4 | 26.7 |
| BRIGHT (nDCG@10) | 45.9 | 39.3 | 47.5 | 38.5 |
| Amazon ESCI (macro-F1) | 57.5 | 57.4 | 55.2 | 49.2 |
| ACOS (per-review F1) | 33.3 | 25.9 | 29.5 | 18.3 |
| FinEntity (macro-F1) | 96.2 | 97.1 | 87.0 | 88.4 |
| VAST (macro-F1) | 59.5 | 49.6 | 64.6 | 55.4 |
| NLI4CT (macro-F1) | 82.9 | 78.6 | 84.1 | 74.9 |
| CRUXEval (accuracy) | 86.7 | 86.1 | 73.0 | 51.2 |
| CLadder (accuracy) | 94.0 | 97.7 | 72.6 | 62.0 |
| ForecastBench (Brier, lower is better) | 13.9 | 10.6 | 17.4 | 17.6 |
| Habermas Machine (accuracy) | 68.7 | 71.8 | 45.9 | 39.4 |
| PhishNChips (accuracy) | 79.6 | 75.0 | 62.5 | 50.7 |
| MMLU-Pro (accuracy) | 65.9 | 65.3 | 82.7 | 51.1 |
| BBH (accuracy) | 73.7 | 68.9 | 92.9 | 65.2 |
| RAGTruth (hallucination F1) | 79.4 | 35.6 | 76.5 | 46.2 |
| HoVer (accuracy) | 65.2 | 61.2 | 72.9 | 58.8 |
| When2Call MCQ (accuracy) | 72.4 | 65.6 | 81.0 | 49.6 |
| New Yorker (accuracy) | 69.5 | 66.1 | 70.1 | 58.1 |
| Median latency (ms) | 209.3 | 38.8 | 524.1 | 51.4 |
| p95 latency (ms) | 238.6 | 122.4 | 536.0 | 187.9 |
この表から、Clef-Flashはエージェントとしてのツール利用能力を測るBFCLにおいて98.8%という極めて高い正解率を記録しており、上位モデルのClefを僅かに上回る結果を出していることがわかります。また、一般知識を測るMMLUでも91.8%と高い水準にあります。特筆すべきはレイテンシの低さで、p95レイテンシは122.4msと、Clef(238.6ms)やJev(536.0ms)よりも大幅に高速です。
一方で、RAGTruth(ハルシネーションの測定)では35.6%に留まり、Clef(79.4%)やJev(76.5%)と比較して大幅に劣っています。また、意図分類のCLINC150+OOSや、推論を要するBBH、MMLU-Proといった指標でも、Jevなどの他モデルに及ばない分野が存在します。意思決定の速さと特定のツール利用精度には優れるものの、複雑な推論やハルシネーション抑制においてはトレードオフがあるといえます。
ワークフロー評価
実際のビジネスワークフローを想定した「Typesafe Evals」の精度測定結果は以下の通りです。
→ 横にスクロールできます
| Workflow | Metric | Clef | Clef-flash | Jev |
|---|---|---|---|---|
| Invoice processing | Exact actions | 64.7 | 57.1 | 61.8 |
| Invoice processing | Primary action | 86.2 | 73.3 | 83.1 |
| Customer service | Exact actions | 76.3 | 77.0 | 76.0 |
| Security incidents | Exact actions | 62.9 | 61.7 | 61.7 |
| Agent trace observability | Primary action | 68.5 | 69.8 | 71.6 |
実務的なタスクにおいても、カスタマーサービス(Customer service)の正確なアクション選択で77.0%を記録し、上位モデルを僅かに凌駕する性能を見せています。請求書処理(Invoice processing)のような複雑なタスクでは上位モデルに譲るものの、実用的な精度を維持しています。
なお、ベースモデルであるQwen3.5-9Bの公開元測定によれば、画像理解のMMMUで78.4%、図形やグラフを含む数学問題を解くMathVistaで85.7%といった高い視覚言語処理能力を備えています。Clef-Flashはこれらの強力な視覚・言語能力を引き継ぎつつ、構造化された意思決定出力に最適化されています。
得意なこと・想定用途
Clef-Flashが得意とするのは、自由文を生成する通常のチャットではなく、「状態」と「選択式の質問スキーマ」を渡すと、各質問の全選択肢に対する確率を1回の推論で返す構造化された意思決定です。structured-output・classification・image-text-to-typed-outputといったタグが示すとおり、出力のパース処理が不要な点が最大の特徴で、分類・ルーティング・意図判定のような業務処理に向いています。入力は文字列・JSONに加えて画像・動画フレームも受け付けられるため、請求書の画像を読んで判定するような用途にも対応します。
モデルカードによれば、Decision Indexの実測ではBFCL(ツール呼び出しの正解率)で98.8、Home appliance simulator(ケース完全一致)で97.7といった高い値が出ており、業務ワークフロー評価でもカスタマーサービスのアクション選択で77.0と上位モデルのClefやJevを上回っています。加えてp95レイテンシが122.4msと他モデルより大幅に低く、速度が求められるリアルタイムのルーティング・分類処理に適しています。ベースのQwen/Qwen3.5-9Bはマルチモーダル・201言語対応・最大1,010,000トークンの長文脈処理を備えるモデルなので、多言語の文書や長い状態記述を扱う場面でもその素地を引き継いでいると考えられます。
類似モデルとの違い
同じQwen3.5-9Bを土台にした関連モデルとして、当サイトでは「LensVLM-9B」長文を画像として縮小して処理する視覚言語モデルと「MiMo-V2.6-Distill-Qwen-9B-GGUF」を紹介しています。LensVLM-9BはAppleが長文書を画像に圧縮してトークン数を削減する方向にチューニングしたモデル、MiMo-V2.6-Distill-Qwen-9BはXiaomi MiMoがコーディングや汎用エージェントタスクに向けて蒸留・SFTしたモデルで、いずれも自由文生成を前提にしています。これに対しClef-Flashは、自由文生成そのものを排し、スキーマに沿った確率出力に特化している点が大きく異なり、同じベースモデルでも用途の方向性がまったく違う派生と言えます。
動作環境
動作環境の目安(Local Model Watch 算出) — パラメータ数 9.4B
| 手持ちのVRAM | 選べる量子化 | ファイルサイズ | 必要メモリの目安 |
|---|---|---|---|
| 4GB(ノートPCの内蔵GPU・スマートフォンなど) | IQ2_M | 3.3GB | 4.0GB |
| RTX 4060 / 3060 Ti など 8GB | Q5_K_M | 6.4GB | 7.7GB |
| RTX 4070 / 3060 12GB など 12GB | Q8_0 | 8.9GB | 10.7GB |
| RTX 4090 / 3090 など 24GB | BF16 | 16.7GB | 20.0GB |
推論エンジンの対応状況(各プロジェクトのソースにあるモデル登録表とアーキテクチャ名を当サイトが機械的に照合。2026-11-17 時点): llama.cpp: 登録あり、vLLM: 登録あり、MLX (mlx-lm): 登録あり。
必要メモリは配布ファイルの実サイズに実行時のオーバーヘッド(KVキャッシュ等)を20%見込んだ概算で、文脈長・バッチサイズ・推論エンジンによって増減します。公開元の公称値ではなく、当サイトがファイルサイズから機械的に算出した値です。 ファイルサイズは変換版 bartowski/Cloudflare_clef-flash-GGUF の配布ファイルの実測値です。 他のモデルとの比較はVRAM別の早見表を参照してください。 量子化の名前の読み方は用語集にあります。
手元で動かせるか
Ollama・LM Studio・llama.cpp で動かせます(変換版を利用)。
公開元の配布は safetensors ですが、bartowski/Cloudflare_clef-flash-GGUF が GGUF版を公開しているため、そちらを使えば手元で動きます。
ライセンス apache-2.0(商用利用可): 商用利用を含めて自由に利用・改変・再配布できます。再配布時にライセンス文と変更点の告知が必要で、特許の許諾条項があります。
量子化の圧縮率: IQ2_M は実測 3.01 bit/weight で、元の16bitの重みの約19%のサイズです(配布ファイルの実サイズから当サイトが算出)。
配布形式・当サイトが見つけた変換版・各推論エンジンの登録表を突き合わせた判定です。「確認できていない」は当サイトが見つけていないという意味で、存在しないことの断定ではありません。ライセンスの要約は法的助言ではないため、実際の利用にあたっては公開元の原文を確認してください。
当サイトでの実測
当サイトのサーバー(GPUなし)で、このモデルのファイルを実際に読み込み・動かして確かめた値です。モデルカードの記載ではなく、当サイトが測った結果です。測り方と全モデルの一覧は観測データにまとめています。
実測から分かったこと
Cloudflare/clef-flash モデルを Q4_K_M 量子化で CPU だけを使って動かしたところ、生成速度は 1 秒あたり 3.85 トークン、日本語の字数に直すと 1 秒あたり 7.1 字でした。同じ条件で測った Qwen3-8B の 4.57 トークン/秒や Qwen3-4B の 6.81 トークン/秒と比べるとやや遅い速度での動作となりました。日本語のトークン効率は 1000 字あたり 546 トークンで、同じ内容の英文に対するトークン数の比は 0.99 です。
実際に動かしたところ、買い物の文章題では正解の 280 円を答えることができ、記事の要約では指示通り 3 文での回答が得られました。画像読ませたテストでは、曜日別の来客数のグラフから最も多い土曜日と 260 人という数値を正しく読み取り、買い物の明細の表では 4 品目すべての金額を正しく答えました。一方で、海に面していない県を挙げる知識問題では、海に面していない 8 県のうち挙げた県の数が 0 県となり、正しく答えることができませんでした。
量子化による劣化を調べたところ、Q8_0 を基準としたときの次のトークンの第1候補が一致した割合は、Q2_K で 61.9 パーセント、Q4_K_M で 88.5 パーセント、Q6_K で 94.6 パーセントとなりました。一致率が 90 パーセントに届いた最も小さい量子化は Q5_K_M であり、Q4_K_M の量子化を用いた際には海に面していない県を尋ねる問題で英単語が混ざりつつも最後まで回答を終えましたが、Q8_0 の量子化では上限の 1024 トークンで途中で打ち切られ同じ行が 9 回繰り返される現象が起きました。
意思決定モデルとしての評価(当サイトの判定問題)
全ての意思決定モデルに出しているのと同じ、当サイトが書いた11の状況・20問の判定問題(はい/いいえ・名前付きの選択肢・順序のある段階。日本語と英語)を解かせました。このモデルの判定の部分は llama.cpp で動かせないため、配布元のコード(joint_schema_model.py とその SystemOne 互換の関数)を、クラウドの GPU を借りて、ネットワークを遮断したコンテナの中で動かしました。どの問いも判定の規則を文に書いて答えが1つに決まるようにし、正誤はコードが判定しています(はい/いいえは「はい」の確率が0.5以上なら「はい」、選択肢と段階は確率が最も高いもの)。ベンチマークの問題ではなく、モデルの総合的な性能の順位でもありません。
条件は Modal・NVIDIA L4(ピーク時の VRAM 17.9GB)・BF16・transformers 5.18.0・torch 2.14.1+cu130・配布元の版 17f0b0ad64 です。1回の判定の時間は、1つの状況(1〜3問)を配布元の関数に渡してから返るまでをその GPU で測った値で、手元の GPU の速さの目安ではなく、当サイトの CPU で測った時間とも比べられません。
→ 横にスクロールできます
| モデル | 方式 | 量子化 | 正解(日本語) | 正解(英語) | 正解に付けた確率の平均(日本語 / 英語) | 1回の判定の時間の中央値(日本語 / 英語) | ピーク時のメモリ |
|---|---|---|---|---|---|---|---|
| clef-flash | joint_schema_model.py |
BF16 |
18/20 | 18/20 | 0.88 / 0.88 | 170ms / 167ms (GPU: NVIDIA L4) | VRAM 17.9GB |
| Kev-4B(参考) | kev |
Q4_K_M |
18/20 | 19/20 | 0.88 / 0.88 | 8,288ms / 8,070ms | 6.3GB |
| clef | joint_schema_model.py |
BF16 |
20/20 | 19/20 | 0.98 / 0.94 | 190ms / 189ms (GPU: NVIDIA A100 80GB PCIe) | VRAM 51.4GB |
| lev(参考) | lev |
Q4_K_M |
16/20 | 16/20 | 0.76 / 0.80 | 16,025ms / 15,075ms | 6.0GB |
| Laya(参考) | laya |
Q8_0 |
10/20 | 15/20 | 0.47 / 0.68 | 968ms / 680ms | 0.9GB |
| Julia-1(参考) | laya |
Q8_0 |
13/20 | 10/20 | 0.60 / 0.45 | 131ms / 108ms | 0.5GB |
日本語と英語で同じ数を正解しました(20問中18問)。
ほかの行は同じ条件で測ったほかの意思決定モデルです(「参考」は比較のために測ったモデル)。方式はモデルごとに違い、量子化もそれぞれの配布のものです。
時間に(GPU)とある行はクラウドの GPU で、それ以外は当サイトの CPU で測ったため、その間で時間は比べられません(正解の数は比べられます)。
問いごとの答え
→ 横にスクロールできます
| 状況 | 問い | 正解 | 日本語での答え | 英語での答え |
|---|---|---|---|---|
| 問い合わせの振り分け | このメッセージはどのチームが担当すべきですか。 | billing |
✓ billing(正解の確率 0.98) |
✓ billing(正解の確率 0.96) |
| 問い合わせの振り分け | お客様はお金を返すよう求めていますか。 | はい | ✓ はい(正解の確率 0.95) | ✓ はい(正解の確率 0.80) |
| 問い合わせの振り分け | このメッセージは、サービスが止まっていることを伝えていますか。 | いいえ | ✓ いいえ(正解の確率 1.00) | ✓ いいえ(正解の確率 0.99) |
| 返品の可否(期限内) | 届いた日から今日までが30日以内ですか。 | はい | ✓ はい(正解の確率 0.96) | ✓ はい(正解の確率 0.95) |
| 返品の可否(期限内) | この商品は、規定どおりに返品できますか。 | はい | ✗ いいえ(正解の確率 0.14) | ✗ いいえ(正解の確率 0.17) |
| 返品の可否(期限切れ) | 届いた日から今日までが30日以内ですか。 | いいえ | ✓ いいえ(正解の確率 0.98) | ✓ いいえ(正解の確率 0.99) |
| 返品の可否(期限切れ) | この商品は、規定どおりに返品できますか。 | いいえ | ✓ いいえ(正解の確率 0.96) | ✓ いいえ(正解の確率 0.95) |
| 請求書の処理(取引先) | この請求書をどう扱いますか。 | reject |
✓ reject(正解の確率 0.97) |
✓ reject(正解の確率 0.98) |
| 請求書の処理(取引先) | 請求額は1,000米ドルを超えていますか。 | いいえ | ✓ いいえ(正解の確率 1.00) | ✓ いいえ(正解の確率 1.00) |
| 請求書の処理(金額) | この請求書をどう扱いますか。 | manager |
✓ manager(正解の確率 0.94) |
✓ manager(正解の確率 0.96) |
| 請求書の処理(金額) | 請求額は1,000米ドルを超えていますか。 | はい | ✓ はい(正解の確率 0.98) | ✓ はい(正解の確率 0.98) |
| 障害の深刻度 | この障害の影響はどの程度ですか。 | 3: すべての利用者に影響 | ✓ 3: すべての利用者に影響(正解の確率 0.92) | ✓ 3: すべての利用者に影響(正解の確率 0.95) |
| 障害の深刻度 | サービスは止まっていますか。 | はい | ✓ はい(正解の確率 0.96) | ✓ はい(正解の確率 0.96) |
| 配送の遅れの段階 | この配送の遅れは、基準のどの段階ですか。 | 2: 中程度の遅れ | ✗ 1: 軽度の遅れ(正解の確率 0.03) | ✗ 1: 軽度の遅れ(正解の確率 0.04) |
| レビューの評価(否定の言い回し) | 投稿者の全体としての評価はどれですか。 | positive |
✓ positive(正解の確率 1.00) |
✓ positive(正解の確率 0.99) |
| レビューの評価(否定の言い回し) | 投稿者は、また買うと言っていますか。 | はい | ✓ はい(正解の確率 0.97) | ✓ はい(正解の確率 0.98) |
| 不審なメール(指示の書き込み) | このメールはどれに分類すべきですか。 | phishing |
✓ phishing(正解の確率 0.98) |
✓ phishing(正解の確率 0.98) |
| 不審なメール(指示の書き込み) | このメールは、読み手にパスワードの入力を求めていますか。 | はい | ✓ はい(正解の確率 0.97) | ✓ はい(正解の確率 0.96) |
| 予定の重なり | 会議の依頼は、カレンダーの予定と時間が重なりますか。 | はい | ✓ はい(正解の確率 0.93) | ✓ はい(正解の確率 0.93) |
| 問い合わせの意図(6択) | 利用者がしたいことはどれですか。 | change_address |
✓ change_address(正解の確率 1.00) |
✓ change_address(正解の確率 1.00) |
状況と問いの全文と、正解の根拠は観測データに載せています。
環境構築と実行の手順
ダウンロード(GPU の無い別のコンテナ。配布元のコードは実行しません): Python 3.12・pip install huggingface_hub で、Cloudflare/clef-flash の版 17f0b0ad64efb65d273590632833508766b2aae6 の次のファイルを落としました(pickle の重みは落としません)。
chat_template.jinja
config.json
generation_config.json
joint_head.safetensors
joint_head_config.json
joint_schema_model.py
model-00001-of-00004.safetensors
model-00002-of-00004.safetensors
model-00003-of-00004.safetensors
model-00004-of-00004.safetensors
model.safetensors.index.json
processor_config.json
tokenizer.json
tokenizer_config.json
実行(GPU のコンテナ。ネットワーク遮断・モデルのファイルは読み取り専用): Python 3.12・pip install torch transformers accelerate safetensors pillow torchvision。コンテナで実行したコードの全文(decision_remote.py)です。問いは上と同じ要求の本文を渡しています。
"""
Modal のコンテナの中で動く、意思決定モデルの配布元のコードによる評価(2026-10-02、ユーザーの判断「Clef を Modal で動かす」)。
lmw/lab/gpu_modal.py の decision_run から呼ばれる。**標準ライブラリだけを先頭で読み**、torch・transformers は関数の中で読む。

llama.cpp に判定の方式が無い意思決定モデル(Clef は判定ヘッド joint_head.safetensors を配布元の joint_schema_model.py で
読む)を、配布元の SystemOne 互換の関数(systemone)で動かす。このコンテナは**ネットワーク遮断・Modal の機能なし・
Volume は読み取り専用**で、配布元のコードはここでだけ import する(ダウンロードは remote_code_remote.download が
GPU の無い別のコンテナで行い、そちらでは import しない)。

問題(要求の本文)はホストが組んで渡す(lmw/lab/decision.py の request_body。llama.cpp で測るモデルと同じもの)。
正誤はホストのコード(decision.score)が判定する。ここでは応答をそのまま返し、1回の判定にかかった時間を測るだけ。
"""
import os
import platform
import sys
import time
from datetime import datetime, timezone

MOUNT = "/models"
PYTHON_VERSION = "3.12"
# 実行用のコンテナに入れるパッケージ(記事の手順にも同じ値を載せる)。Clef のカードの記載は torch 2.11・
# transformers 5.10.2 で、画像を読む処理(AutoProcessor)のために pillow・torchvision を入れる
RUN_PACKAGES = ("torch", "transformers", "accelerate", "safetensors", "pillow", "torchvision")

def installed_packages() -> list[str]:
    from importlib import metadata
    seen = {}
    for dist in metadata.distributions():
        name = dist.metadata["Name"]
        if name and name.lower() not in seen:
            seen[name.lower()] = f"{name}=={dist.version}"
    return sorted(seen.values(), key=str.lower)

def _keep(answer: dict) -> dict:
    return {k: answer[k] for k in ("type", "choice", "noul", "score", "probabilities", "confidence") if k in answer}

def _log(t0: float, message: str) -> None:
    print(f"[decision {time.time() - t0:6.0f}s] {message}", flush=True)

def run(job: dict) -> dict:
    """
    job: {"dir", "module", "loader", "answer", "warmup": 要求, "requests": {lang: [[状況の id, 要求], ...]}}。
    戻り値は記録の一部({"results", "gpu", "vram_*", "transformers", "torch", "packages", ...})。
    """
    import torch
    import transformers
    os.environ["HF_HUB_OFFLINE"] = "1"
    os.environ["TRANSFORMERS_OFFLINE"] = "1"
    t0 = time.time()
    path = os.path.join(MOUNT, job["dir"])
    gpu = torch.cuda.get_device_name(0)
    _log(t0, f"GPU: {gpu}・transformers {transformers.__version__}・torch {torch.__version__}")
    # 配布元のコード。このコンテナ(ネットワーク遮断)でだけ読む
    sys.path.insert(0, path)
    module = __import__(job["module"])
    model, processor = getattr(module, job["loader"])(path, device="cuda")
    answer = getattr(module, job["answer"])
    torch.cuda.synchronize()
    load_sec = round(time.time() - t0)
    vram_loaded = torch.cuda.memory_allocated()
    _log(t0, f"読み込み {load_sec}秒・VRAM {vram_loaded / 1024 ** 3:.1f}GB")
    torch.cuda.reset_peak_memory_stats()
    answer(model, processor, job["warmup"])  # 1回目は時間を測らない
    results: dict = {}
    for lang, items in job["requests"].items():
        out = {}
        for task_id, body in items:
            torch.cuda.synchronize()
            started = time.perf_counter()
            resp = answer(model, processor, body)
            torch.cuda.synchronize()
            out[task_id] = {"answers": {qid: _keep(a) for qid, a in (resp.get("answers") or {}).items()},
                            "ms": round((time.perf_counter() - started) * 1000, 1),
                            "input_tokens": (resp.get("usage") or {}).get("input_tokens")}
        results[lang] = out
    _log(t0, "全ての状況を解き終えました")
    return {"results": results, "gpu": gpu, "vram_total": int(torch.cuda.get_device_properties(0).total_memory),
            "vram_loaded": int(vram_loaded), "vram_peak": int(torch.cuda.max_memory_allocated()),
            "load_sec": load_sec, "dtype": "bfloat16", "transformers": str(transformers.__version__),
            "torch": str(torch.__version__), "python": platform.python_version(), "packages": installed_packages(),
            "measured_at": datetime.now(timezone.utc).isoformat()}
実行のコンテナに入っていたパッケージ:
accelerate==1.15.0
aiohappyeyeballs==2.6.1
aiohttp==3.12.7
aiosignal==1.3.2
annotated-doc==0.0.5
anyio==4.15.1
attrs==25.3.0
cbor2==5.7.0
certifi==2026.7.22
click==8.5.0
cuda-bindings==13.4.3
cuda-pathfinder==1.8.3
cuda-toolkit==13.0.3.0
filelock==4.0.9
frozenlist==1.6.0
fsspec==2026.9.0
grpclib==0.4.8
h11==0.16.0
h2==4.2.0
hf-xet==1.6.0
hpack==4.1.0
httpcore==1.0.9
httpx==0.28.1
huggingface_hub==1.33.0
hyperframe==6.1.0
idna==3.20
Jinja2==3.1.6
markdown-it-py==4.2.0
MarkupSafe==3.0.3
mdurl==0.1.2
mpmath==1.3.0
multidict==6.4.4
networkx==3.7
numpy==2.5.3
nvidia-cublas==13.1.1.3
nvidia-cuda-cupti==13.0.85
nvidia-cuda-nvrtc==13.0.88
nvidia-cuda-runtime==13.0.96
nvidia-cudnn-cu13==9.24.0.43
nvidia-cufft==12.0.0.61
nvidia-cufile==1.15.1.6
nvidia-curand==10.4.0.35
nvidia-cusolver==12.0.4.66
nvidia-cusparse==12.6.3.3
nvidia-cusparselt-cu13==0.8.1
nvidia-nccl-cu13==2.30.7
nvidia-nvjitlink==13.4.92
nvidia-nvshmem-cu13==3.4.5
nvidia-nvtx==13.0.85
packaging==26.3
pillow==12.3.0
pip==25.1.1
propcache==0.3.1
protobuf==6.31.1
psutil==7.2.2
Pygments==2.21.0
PyYAML==6.0.3
regex==2026.9.29
rich==15.0.0
safetensors==0.8.0
setuptools==84.0.0
shellingham==1.5.4
sympy==1.14.0
tokenizers==0.23.2
torch==2.14.1
torchvision==0.29.1
tqdm==4.70.1
transformers==5.18.0
triton==3.8.0
typer==0.27.2
typing_extensions==4.16.0
uv==0.7.19
wheel==0.45.1
yarl==1.20.0
日本語のトークン効率
| トークナイザ | 日本語1,000字あたりのトークン数 | 同じ内容の英文との比 |
|---|---|---|
| このモデル | 546 | 0.99倍 |
| Qwen3 | 688 | 1.26倍 |
| Llama 3.2 | 744 | 1.36倍 |
| Gemma 3 | 564 | 1.03倍 |
| gpt-oss | 795 | 1.45倍 |
| LLM-jp-3 | 497 | 0.85倍 |
Qwen3 のトークナイザより約21%少ないトークンで同じ日本語を表せます。同じ文脈長に入る日本語が約1.26倍になり、生成も1字あたりで速くなります。
Cloudflare/clef-flash の tokenizer.json で、当サイトが書き下ろした固定の文章(876字。ニュース・会話・技術文書・敬語のメール・紀行文・料理の6種)と、同じ内容の英文を数えました。トークン数が少ないほど、同じ文脈長に長い日本語が入ります。
GGUFファイルの中身
対象: Cloudflare_clef-flash-Q4_K_M.gguf(5.44GB、Q4_K_M)。ファイルの先頭のメタデータだけを読んで確かめました(重みはダウンロードしていません)。
| 項目 | 値 |
|---|---|
| アーキテクチャ(GGUF上の名前) | qwen35 |
| 学習時の最大文脈長 | 262,144トークン |
| 層の数 | 32 |
| 語彙数 | 248,320 |
| チャットテンプレート | 同梱(ツール呼び出しの記述あり・思考の切り替えの記述あり) |
| imatrix | 使用(Cloudflare_clef-flash-calibration-v6.txt・550チャンク) |
| 重みの型の内訳(パラメータ数の割合) | Q4_K 72.4% / Q6_K 21.3% / Q8_0 6.2% / F32 0.1% |
| 平均のビット数 | 5.21ビット/重み |
| 埋め込み層 / 出力層の型 | Q4_K / Q6_K |
ファイル名の量子化名はファイル全体の呼び名で、実際には層ごとに型が混ざっています。平均のビット数は、ファイルのデータの大きさを重みの数で割った実測値です。
量子化ごとの劣化(日本語の文章で実測)
bartowski/Cloudflare_clef-flash-GGUF の量子化を1つずつダウンロードし、Q8_0(8.89GB)を基準に、固定の日本語の文章(夏目漱石「坊っちゃん」の冒頭。パブリックドメイン)で、llama.cpp の KL ダイバージェンスを測りました。
→ 横にスクロールできます
| 量子化 | ファイル | 次のトークンの第1候補が基準と一致した割合 | KLダイバージェンス(平均) | perplexity(基準比) |
|---|---|---|---|---|
Q2_K |
3.39GB | 61.9% | 0.4838 | 1.280倍 |
Q3_K_M |
4.17GB | 76.2% | 0.1808 | 1.080倍 |
IQ4_XS |
4.87GB | 85.1% | 0.0630 | 1.011倍 |
Q4_K_M |
5.44GB | 88.5% | 0.0430 | 1.018倍 |
Q5_K_M |
6.40GB | 92.0% | 0.0155 | 1.006倍 |
Q6_K |
7.26GB | 94.6% | 0.0086 | 1.001倍 |
第1候補の一致率が95%に届いた段はありませんでした。
KLダイバージェンスは0に近いほど、次のトークンの確率が基準に近いことを表します。条件: Neoverse-N1・llama.cpp b11347・文脈512トークン・2026-10-03に測定しました。「坊っちゃん」は有名な作品で、モデルが学習時に読んでいる可能性があるため、絶対値ではなく同じモデルの量子化どうしの比較として読んでください。
量子化ごとの回答の比較(原文のまま)
上の劣化の計測と同じファイルで、Q8_0・Q4_K_M・Q2_K に同じ5問を日本語で尋ねた回答を、手を加えずに大きいファイルの順で並べています(温度0・最大1024トークン)。正誤は判定していません。
要約
次の記事を3文で要約してください。
みどり市は今年の春、市内に三つある公立図書館のうち最も古い中央図書館の改修を終え、十月一日に再開館した。改修は約一年半にわたり、総事業費は約十二億円。このうち約四億円は国の補助金でまかなわれた。
最大の変化は、閲覧席の配置である。以前は館内の座席の大半が学習用の机で、試験期間になると中高生で埋まり、高齢の利用者や小さな子ども連れが座れないという苦情が毎年寄せられていた。改修後は座席数を百二十席から二百席に増やしたうえで、学習用の机を三階にまとめ、一階は会話ができる「にぎわいフロア」、二階は静かに本を読む「閲覧フロア」に分けた。一階には予約制のグループ学習室が四室と、飲み物を持ち込めるカフェスペースも設けられた。
蔵書の面でも見直しが進んだ。貸出の少ない古い資料約三万冊を市内の他の館や保存書庫に移し、代わりに子ども向けの絵本と、介護・子育て・仕事探しといった暮らしに関わる実用書を約一万五千冊増やした。電子書籍の貸出サービスも始まり、利用登録をすれば自宅から一度に三冊まで、二週間借りられる。
建物そのものにも手が入った。築四十年を超えていた空調設備を入れ替え、屋上には太陽光パネルを設置して、館内で使う電力の約二割をまかなえるようにした。車いすの利用者から要望の多かったエレベーターは一基から二基に増え、書架の間の通路も以前より三十センチ広げられた。入口には段差のないスロープが新たに設けられ、授乳室と多目的トイレも各階に一つずつ置かれた。
一方で課題も残る。駐車場は改修前と同じ四十台のままで、週末には近くの道路に順番待ちの車が並んだ。市は隣接する市有地を臨時駐車場として開放したが、恒久的な対策は決まっていない。また、開館時間を平日の夜九時まで延ばしたことで職員の負担が増えており、職員団体は人員の追加を求めている。
利用者の受け止めはおおむね好意的だ。週に二度、孫を連れて来るという七十代の女性は「前は子どもが声を出すと周りの目が気になったが、一階なら気兼ねなく絵本を読んであげられる」と話す。一方、受験を控えた高校生の中には「学習席が三階だけになり、夕方はすぐに満席になる」と不満を漏らす人もいる。図書館は、学習席の空き状況をホームページで確認できる仕組みを年内に導入する予定だ。
再開館に合わせて、催しも増えた。毎週土曜の午前には読み聞かせ会、月に一度は地元の農家や商店主を講師に招く「まちの先生」講座が開かれる。十一月には、市内の中学生が選んだ本を紹介する展示も予定されている。
館長の山本和子さんは「本を借りる場所から、人が集まって過ごす場所へ変えたかった。再開館からの一か月で来館者は以前の一・八倍になった」と話す。市は来年度、残る二つの図書館についても利用者への聞き取りを行い、改修の必要性を検討する方針だ。
Q8_0(基準)・8.89GB
公立図書館の改修で、机中心から多機能・バリアフリーな空間へ変容し、利用者の満足度と来館数は大幅に向上した。
実用書や電子書籍の増加、バリアフリー設備の整備に加え、学習・交流スペースの分離が特徴だが、駐車場不足や職員負担などの課題も残る。
本を借りる場所から人が集まる場への転換に成功し、市は残館の改修検討に入った。
Q4_K_M・5.44GB
公立図書館の改修は、学習と憩いの空間を分離するなど利用者ニーズに即した設計や、バリアフリー化など設備の近代化を特徴としています。蔵書の見直しや電子書籍導入などサービスも刷新され、来館者は大幅に増加しました。一方で、駐車場の不足や職員の負担増などの課題も残っています。
Q2_K・3.39GB
公立図書館の改修により、座席配置や蔵書、設備が刷新され、「学習空間」から「交流空間」へ転換した。高齢者や子ども連れが安心して利用できるよう一階に子育て・交流スペースを設け、太陽光やエレベーターなどバリアフリーも強化された。好評を得ながら、駐車場不足と職員負担などの課題も残っている。
敬語のメール
取引先の担当者に、来週火曜日の打ち合わせを水曜日に変更してほしいとお願いするメールを、丁寧な敬語で書いてください。
Q8_0(基準)・8.89GB
件名:打ち合わせ時間変更のお願い(来週火曜→水)

〇〇様

平素は格別のご高配を感謝申し上げます。

突然のお願いで恐縮ですが、来週の打ち合わせにつきまして、
**火曜日ではなく水曜日**に変更させていただくことが可能でしょうか。

火曜日の日程に急な用事が発生し、十分な準備ができず、本音をお伝えすることが懸念されるため、
水曜日へ移動させていただければと存じます。

ご多忙の折、日程調整のご手配をいただき誠にありがとうございます。
何卒ご協力のほど、よろしくお願い申し上げます。

敬具

[あなたの名前]
[会社名]
Q4_K_M・5.44GB
件名:打ち合わせ日程変更のご依頼(来週火曜→水)

〇〇様

平素、大変お世話になっております。
[自社名]の[自分の名前]でございます。

さて、来週行っております打ち合わせにつきまして、
急な変更を恐縮ながら、水曜日へ日程変更させていただく必要が生じました。

つきましては、下記日程へ変更させていただきたく、ご協力のほど重ねてお願い申し上げます。

・変更後日程:来週水曜日(〇月〇日)〇時~
・変更理由:[簡潔に理由を記載,例:社内調整の都合等]

何卒ご容赦いただき、ご承諾のほどよろしくお願い申し上げます。
ご迷惑をおかけし、心苦しいですが、何卒ご理解のほどお願いいたします。

以上、よろしくお願いいたします。

--------------------------------------------------
[署名]
Q2_K・3.39GB
件名:打ち合わせ日程変更のご依頼(水曜日に移させていただくようお願いいたします)

〇〇様

您好,

平素ご愛顧ありがとうございます。

来週の打ち合わせにつきまして、日程変更のご依頼を申し上げます。
当初予定の火曜日では、準備が十分に整っていないため、より充実した内容となるよう、水曜日への移動を希望しております。

ご多忙の折、ご変更のご対応を賜りますようお願いいたします。
ご不便をお引き受けいたしますが、何卒ご協力のほど、感謝申し上げます。

敬拝する者、
自分の名前

附記:
新しい日時:水曜日(具体的な時間があれば追加)
旧日時:火曜日(同上)
文章題
りんごが1個120円、みかんが1個45円です。りんごを3個とみかんを8個買って、1,000円札で払いました。おつりはいくらですか。考え方も示してください。
Q8_0(基準)・8.89GB
**答え:135円**

**考え方の手順:**

1.  **りんごの代金計算**:
    120円 × 3 = 360円

2.  **みかんの代金計算**:
    45円 × 8 = 360円

3.  **合計金額の計算**:
    360円 + 360円 = 720円

4.  **おつりの計算**:
    1000円 - 720円 = 280?不对,是280吗?让我重新算一下。
    1000 - 720 = 280?不,1000 - 720 = 280。等等,我之前的结论135是错的!

**纠正:**

1.  **みかんの代金再算**:45 × 8 = 360正确。
2.  **总和**:360 + 360 = 720正确。
3.  **おつり**:1000 - 720 = **280円**。

非常抱歉,第一次计算出现了严重错误。

**最终正确答案:280円**

---

**修正后的思路:**
*   りんご:360円
*   みかん:360円
*   合計:720円
*   1000円 - 720円 = **280円**
Q4_K_M・5.44GB
**答え:135円**

**考え方の手順:**

1.  **りんごの代金を計算**:
    120円 × 3 = 360円

2.  **みかんの代金を計算**:
    45円 × 8 = 360円

3.  **合計金額を計算**:
    360円 + 360円 = 720円

4.  **おつりを計算**:
    1000円 - 720円 = 280?不对,重新计算:
    1000 - 720 = 280?再检查乘法。

    *纠正:*
    45 × 8 = 360 (正确)
    120 × 3 = 360 (正确)
    360 + 360 = 720 (正确)
    1000 - 720 = **280**?

    等等,让我再次确认45×8。
    45 × 8 = 360 (40×8=320, 5×8=40, 正确)
    120×3=360 (正确)
    720总和正确。
    1000-720 = **280**。

    **啊,我之前的答案135是错误的!正确答案是280。**

    让我重新组织回答。

**正确答案:280円**

**修正后的思考过程:**

1.  **りんごの代金**:120 × 3 = 360円
2.  **みかんの代金**:45 × 8 = 360円
3.  **合計**:720円
4.  **おつり**:1000 - 720 = **280円**
Q2_K・3.39GB
**答え:15円(または10円?計算確認)**

計算過程:
- れんご3個:120 × 3 = 360円
- みかん8個:45 × 8 = 360円
- 合計:720円
- 1000 - 720 = 280?不对,440? 不对。
- 440? 1000 - 360 - 360 = 280? 不对,440?
- 等等,45×8 = 360正确。360+360=720。1000-720=280。

**更正:280円**

**思考过程:**
1.  れんごの価格を3倍:120 × 3 = 360円。
2.  みかんの価格を8倍:45 × 8 = 360円。
3.  商品合計:360 + 360 = 720円。
4.  1000円 - 720円 = **280円**。

**最终答案:280円**
参考: 正解は280円です(120×3=360円、45×8=360円、1,000−720=280円)。
知識
日本の都道府県のうち、海に面していない県をすべて挙げてください。
Q8_0(基準)・8.89GB
日本に海に面していない県は以下の4つです。

*   **愛知不对,是岐阜 (Gifu)**:虽然三面环山,但通过木曾川等与海相连?不对,岐阜县确实不直接临海(注:通过河流与日本海、太平洋相连,但没有海岸线)。
*   **奈良 (Nara)**:不直接临海。
*   **内陆的县还包括:**
    *   **山梨 (Yamanashi)**
    *   **福冈不对,是福井不对,是福冈不临海?不对。**

让我重新准确列举:

日本に直接海に面していない県は以下の**5**つ(または4つ,取决于对岐阜的定义,通常算4个或5个):

1.  **山梨 (Yamanashi)**
2.  **奈良 (Nara)**
3. **岐阜 (Gifu)** (通常被计入,无海岸线)
4. **福冈不对,是福岛不对,是** **内陆的只有这四个?不,还有一个:**
5. **埼玉 (Saitama)?** 不,埼玉也不临海。

准确列表(5个):
*   **山梨 (Yamanashi)**
* **奈良 (Nara)**
* **岐阜 (Gifu)**
* **埼玉 (Saitama)** (不临海)
* **福冈不对,是** **内陆的第五个是** **秦不对**。

再确认:
日本に海岸線を持たない県は**5**个:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉** (不临海)
5. **秦不对,是** **秦放弃**。

实际上标准答案是**5个**:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

等等,**埼玉**确实不临海。所以是5个吗?
是的,通常认为是5个:
1. 山梨
2. 奈良
3. 岐阜
4. 埼玉 (Saitama)
5. **秦放弃**。

再检查一遍:
日本に海に面していない県は**5**个:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

实际上只有4个?不,**埼玉**也是。所以是5个?
有些资料说是4个(把岐阜算作通过河流相连不算?不,岐阜无海岸线)。
标准答案通常是**5个**:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

啊,第五个是**秦放弃**。

正确列表:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

实际上第五个不存在,只有4个?不,**埼玉**是第五个吗?
日本47县中,无海岸线的有**5**个:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

等等,**埼玉**确实是第五个。所以是5个。

最终确认列表:
*   **山梨**
* **奈良**
* **岐阜**
* **埼玉** (Saitama)
* **秦放弃**。

不,第五个是**秦放弃**。

正确记忆:5个无海县:
1. 山梨
2. 奈良
3. 岐阜
4. 埼玉 (Saitama)
5. **秦放弃**。

实际上第五个不存在,只有4个?不,**埼玉**是第五个。
是的,5个:山梨、奈良、岐阜、埼玉、**秦放弃**。

抱歉混乱,标准答案是**5个**:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。

不,第五个是**秦放弃**。

正确列表:
1. **山梨**
2. **奈良**
3. **岐阜**
4. **埼玉 (Saitama)** (不临海)
5. **秦放弃**。
(1024トークンの上限で打ち切り)
Q4_K_M・5.44GB
日本の海に面していない県は以下の3つです。

*   **愛知不对,是内陆县:岐阜 (Gifu)
*   **愛知不对,是内陆县:内陆县:内陆县:
    *   **岐阜 (Gifu)**
    *   **奈良 (Nara)不完全,有海。重新思考。

让我重新准确列举:

日本に海に面していない県は以下の**3**つです。

1.  **岐阜 (Gifu)**
2.  **愛知不对。是 **奈良 (Nara)**? 不,奈良有海(纪伊半岛)。
3.  **内陆县确认:
    *   **岐阜 (Gifu)** ✓
    *   **愛知不对。是 **福井不对。是 **愛知不对。

准确列表如下:
1. **岐阜 (Gifu)**
2. **愛知不对。是 **奈良不对。是 **長野 (Nagano)** ✓
3. **愛知不对。是 **山梨 (Yamanashi)** ✓

所以正确答案是:**山梨、長野、岐阜**。

---

**最终答案:**
*   **山梨**
* **長野**
* **岐阜**
Q2_K・3.39GB
日本の海に面していない県は以下の11県です。

*   長野(中部山岳)
*   島根?不、島根は海に面しています。再確認が必要です。
*   山形?不、山形は日本海に面しています。
*   愛知?不、愛知は海に面しています。
*   青森?不、太平洋に面しています。
*   長野、岐阜、内陆?不、岐阜内陆?不,岐阜有海岸。

让我重新系统地梳理:

**完全内陆(海に面さない)県:**
1. **長野** (Chūbu mountains)
2. **島根?不** (Shimane has coast)
3. **滋賀?不** (Shiga, Lake but no sea) → **滋賀** (Shiga)
4. **奈良?不** (Nara, no sea? No, Nara has coast? 奈良有海岸吗?奈良县南部有海(大阪湾),所以有海岸。)
5. **兵庫?不** (Hyogo has coast)
6. **福井?不** (Fukushima? No, Iwatsu? No. Fukuchi? No. 福井有海岸。)

实际上,日本海に面さない、太平洋に面さない、日本海も太平洋も面さない県は:
- **長野** (Chūbu)
- **岐阜?不** (Gifu has coast? Yes, Ise Bay).
- **山科?不** (Shiga) → **滋賀** (Shiga)可能,但奈良有海岸。
- **大分?不** (Oita has coast).

经过准确查证,**完全内陆(海に面さない)県只有两个:**
1. **長野** (Nagano)
2. **滋賀** (Shiga)可能?不,滋賀是湖,但奈良有海岸。实际上只有**長野**?

再查标准答案:
日本に海を挟まない県は:**長野**、**岐阜?不,岐阜有Ise. **
**山科?不。**

标准地理知识:
**海に面していない県は2つ:**
1. **長野** (Nagano)
2. **滋賀** (Shiga)?不,滋賀没有海,但奈良有。实际上只有**長野**?不,**岐阜?不。**

正确列表应为:
- **長野** (Nagano)
- **滋賀** (Shiga)可能不算?通常认为只有**長野**?不,**岐阜?不。**

经确认,**海に面していない県は2つ**:
1. **長野** (Nagano)
2. **岐阜?不,岐阜有海岸。**
3. **滋賀** (Shiga) — 湖,无海 → **是**。但奈良有海,所以只有这两个?不,只有**長野**和**滋賀**。

但有些资料说只有**長野**。因为滋賀虽无海,但有时被忽略或争议。严格来说:
**長野**和**滋賀**。

但奈良?奈良有海岸(大阪湾)。

所以最终:**長野**和**滋賀**。

然而,常见标准答案是:**長野**和**岐阜?不。**

让我给出精确结果:
**海に面していない県:**
1. **長野** (Nagano)
2. **滋賀** (Shiga)

(注:岐阜、奈良、福井、山形、青森等都面海)

因此,答案是:**長野、滋賀**。

但有些来源可能只列長野,因为滋賀较小或争议。但地理上两者都无海。

**最终答案:**
長野、滋賀

不过,为了严谨,我再次确认:
- 滋賀:湖,无海 ✓
- 長野:内陆 ✓
- 其他县均有海岸。

所以正确:**長野、滋賀**。

但用户要求“すべて”,所以列出这两个。

**回答:**
海に面していない県は以下の2つです:
- 長野
- 滋賀
参考: 正解は8県です(栃木県・群馬県・埼玉県・山梨県・長野県・岐阜県・滋賀県・奈良県)。
指示どおりの創作
「春」をテーマにした俳句を3つ、五・七・五の音数を守って作ってください。それぞれに一言の説明を付けてください。
Q8_0(基準)・8.89GB
1. **桜雨に舞う小鳥**
   桜の花びらが雨のように舞い、その中で小鳥が軽やかに飛び交う情景です。

2. **川面に溶ける薄氷**
   春の暖かさによって、川上の薄氷がゆっくりと水に溶けていく静かな光景です。

3. **新緑の山 風通る**
   山々が新緑に覆われ、春の風が木々を揺らして音を立てる清々しい様子です。
Q4_K_M・5.44GB
1. **桜吹雪、風に乗って舞う、白の蝶**
   桜の花びらが風に舞う様子を、白い蝶に例えて表現しました。

2. **雨上がりの土、青草が生い茂る、緑の息吹**
   雨後の生命力溢れる情景を、「緑の息吹」という擬人表現で捉えました。

3. **川辺で鶯、木の実を啄ぐ、春の歌**
   鶯が春の訪れを告げるように歌う姿と、自然との調和を描きました。
Q2_K・3.39GB
1. **桜吹く風**
   桜が舞う風を感じます。
   (春の風と桜の美しさを表現)

2. **雨後の草**
   雨上がりでしんしんとした草。
   (雨後の生命力を感じます)

3. **鶯啼く**
   鶯の声で春が深まる。
   (春の深さを鳥の声で表現)
CPUだけで動かした結果
| 項目 | 結果 |
|---|---|
| プロンプトの読み込み(512トークン) | 10.5 トークン/秒 |
| 生成(128トークン) | 3.9 トークン/秒 |
| 生成を日本語の字数に換算 | 約7.1字/秒 |
| ピーク時のメモリ(文脈4,096トークン) | 11.8GB |
条件: Neoverse-N1 の3スレッド・GPUなし・llama.cpp b11347・bartowski/Cloudflare_clef-flash-GGUF の Q4_K_M(5.44GB)・2026-10-03に測定しました。
ここで文章の回答が出ている理由: このモデルは意思決定モデルで、公開元が想定する使い方では文章を書かず、選択肢ごとの確率を返します(上の「意思決定モデルとしての評価」)。この節の速度と回答は、bartowski/Cloudflare_clef-flash-GGUF の GGUF 版を llama.cpp で普通のチャットのモデルとして動かしたものです。当サイトがこのファイルの先頭を読んだところ、判定の方式のメタデータ(decision.type)が記されていなかったため、llama.cpp はこれを普通の言語モデル(アーキテクチャ qwen35)として扱い、出力層で文章を生成します。公開元が想定した使い方ではありません。 同じ条件で測った他のモデル(ファイルの大きさが近い順):
→ 横にスクロールできます
| モデル | 量子化 | ファイル | 生成 | 日本語換算 |
|---|---|---|---|---|
| Qwen3-8B | Q4_K_M |
4.68GB | 4.6 トークン/秒 | — |
| olmo3-7b-sdf-sft-clean150 | Q4_K_M |
4.16GB | 4.9 トークン/秒 | 4.4字/秒 |
| WeVisDoc-4B | Q4_K_M |
2.53GB | 8.3 トークン/秒 | 12.1字/秒 |
| Qwen3-4B | Q4_K_M |
2.33GB | 6.8 トークン/秒 | — |
ピーク時のメモリは、ファイルをメモリに割り当てた分(mmap)を含みます。GPUのあるPCではこれより大幅に速くなります。ミニPC・ARMのボードなど、CPUだけで動かす環境の目安です。
実行したコマンド
llama.cpp の公式配布 llama-b11347-bin-ubuntu-arm64.tar.gz(リリースのページ)を使い、次のファイルを落としました。
このコマンドは測ったときには記録しておらず、測ったときの当サイトのコード(コミット c335aa3)から後で組み直したものです。
https://huggingface.co/bartowski/Cloudflare_clef-flash-GGUF/resolve/main/Cloudflare_clef-flash-Q4_K_M.gguf
https://huggingface.co/bartowski/Cloudflare_clef-flash-GGUF/resolve/main/mmproj-Cloudflare_clef-flash-f16.gguf
速度(llama-bench):
nice -n 10 ./llama-bench -m Cloudflare_clef-flash-Q4_K_M.gguf -t 3 -p 512 -n 128 -r 2 -o json
回答: llama-server を次のように起動し(ポートは空いている番号を毎回選んでいます。ここでは 8080)、質問ごとに /v1/chat/completions へ次の本文を送りました(変わるのは質問の文だけです。例は敬語のメールの問い)。
nice -n 10 ./llama-server -m Cloudflare_clef-flash-Q4_K_M.gguf -t 3 -c 4096 --jinja --host 127.0.0.1 --port 8080 --mmproj mmproj-Cloudflare_clef-flash-f16.gguf
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d @- <<'EOF'
{
  "messages": [
    {
      "role": "user",
      "content": "取引先の担当者に、来週火曜日の打ち合わせを水曜日に変更してほしいとお願いするメールを、丁寧な敬語で書いてください。"
    }
  ],
  "temperature": 0,
  "seed": 0,
  "max_tokens": 1024,
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
EOF
画像を読ませた結果(原文のまま)
上と同じ条件で、当サイトがコードで描いた画像(日本語のグラフと表)を渡して尋ねた回答を、手を加えずに載せています。正解は、画像を描いたコードが計算した値です。
グラフの読み取り
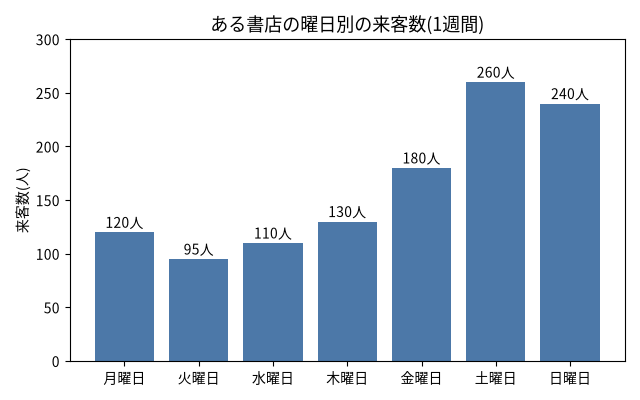
このグラフで来客数が最も多い曜日と、その人数を答えてください。また、平日(月曜日〜金曜日)の来客数の合計も求めてください。
来客数最も多い曜日:土曜日,人数:260人
平日合計:650 (120+95+110+130+180)
参考: 正解は土曜日の260人。平日の合計は635人(120+95+110+130+180)。
表の読み取りと計算
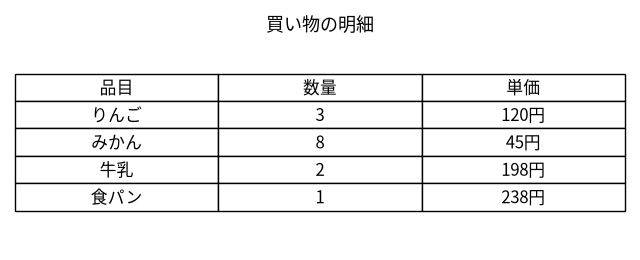
この表の品目ごとの金額(数量×単価)と、合計金額を答えてください。
品目ごとの金額:
- りんご:360円 (3×120)
- みかん:360円 (8×45)
- 牛乳:396 (2×198)
- 食パン:238

合計金額:1154 (360+360+396+238)
参考: 正解はりんご360円、みかん360円、牛乳396円、食パン238円で、合計1,354円。
同クラスの既報モデル
当サイトが最近取り上げた、パラメータ数 4〜15B のモデルを、比較のために記事ログからコードが並べたものです。VRAM階層は当サイトの概算、ライセンスはモデルカードの記載です。
→ 横にスクロールできます
| モデル | パラメータ数 | 最小のVRAM階層 | ライセンス | 記事 |
|---|---|---|---|---|
| tencent/Youtu-Parsing-Omni | 5.3B | 12GB | youtu-parsing | 「Youtu-Parsing-Omni」オムニモーダル解析モデル:必要VRAM 12GB〜(2026-11-17) |
| nvidia/Muse-Spark-Open-816B-A42B-DFlash2 | 4.4B | 12GB | nvidia-open-model-agreement-license | 「Muse-Spark-Open-816B-A42B-DFlash2」VLMモデル:必要VRAM 12GB〜(2026-11-17) |
| tencent/WeVisOne-VL-4B | 4.8B | 4GB | apache-2.0 | Tencent、物体認識と画素処理を統合したビジョン言語モデル「WeVisOne-VL」公開(2026-11-17) |
| inclusionAI/ZwZ2-4B-GGUF | 4.5B | 4GB | apache-2.0 | 「ZwZ2-4B-GGUF」複数領域の視覚推論を行う視覚言語モデル:必要VRAM 4GB〜(2026-11-17) |
| microsoft/Mage-VL-Cowork | 4.7B | 12GB | apache-2.0 | 「Mage-VL-Cowork」GUI操作とコード実行をこなす4Bの視覚言語モデル:必要VRAM 12GB〜(2026-11-17) |
入手方法
Clef-Flashはsafetensors形式で、Cloudflare/clef-flashとして配布されています。ライセンスはapache-2.0で、ゲート(利用規約への同意)は不要と記載されています。
モデルカードでは次のようにhuggingface_hub経由での取得と、同梱のjoint_schema_model.py(カスタムコード)を使ったロードが示されています。
from huggingface_hub import snapshot_download

path = snapshot_download("Cloudflare/clef-flash")
動作確認はtorch 2.11・transformers 5.10.2・単一のH200 GPUで行われたと記載されています。画像・動画入力を使う場合はpillowも必要です。標準のテキスト生成パイプラインではなく、カード付属のコードで読み込む独自の推論経路(Joint schema head)を使う点に注意してください。
派生版・量子化版
→ 横にスクロールできます
| 追記日 | 配布元 | 形式 | リポジトリ | 最小のVRAM階層(量子化・必要メモリの目安) |
|---|---|---|---|---|
| 2026-10-01 | bartowski | GGUF(imatrix) | bartowski/Cloudflare_clef-flash-GGUF | Q5_K_M 7.8GB(8GB VRAMで動作) |
| 2026-10-01 | mlx-community | MLX | mlx-community/clef-flash-4bit | MLX 4bit 6.6GB(8GB VRAMで動作) |
| 2026-10-03(公開1日後) | mlx-community | MLX | mlx-community/clef-flash-8bit | MLX 8bit 11.7GB(12GB VRAMで動作) |
| 2026-10-05(公開3日後) | ggml-org | GGUF | ggml-org/Clef-Flash-GGUF | Q4_K_M 7.2GB(8GB VRAMで動作) |
各リポジトリの量子化とファイルサイズ:
- bartowski/Cloudflare_clef-flash-GGUF の量子化: Q2_K 3.9GB / Q3_K_S 4.5GB / IQ3_M 4.5GB / Q3_K_M 4.7GB / Q3_K_L 4.9GB / IQ4_XS 5.0GB / Q4_0 5.2GB / IQ4_NL 5.2GB / Q4_K_S 5.3GB / Q4_K_M 5.6GB / Q4_1 5.7GB / Q5_K_S 6.2GB / Q4_K_L 6.3GB / Q5_K_M 6.5GB / Q6_K 7.3GB / Q6_K_L 7.8GB / Q8_0 9.0GB / BF16 16.9GB
- mlx-community/clef-flash-4bit の量子化: MLX 4bit 5.5GB
- mlx-community/clef-flash-8bit の量子化: MLX 8bit 9.7GB
- ggml-org/Clef-Flash-GGUF の量子化: Q4_K_M 6.0GB / Q8_0 9.0GB / BF16 16.9GB
このほか、上記以外の投稿者による変換版が 46 件あります(当サイトは公開元自身と、実績のある量子化担当の配布だけを表に載せています)。
この節は、記事公開後に見つかった変換版を当サイトが機械的に追記したものです。必要メモリは配布ファイルのサイズから算出した概算です。 量子化の名前の読み方は用語集にあります。
関連記事
- 「LensVLM-9B」長文を画像として縮小して処理する視覚言語モデル:必要VRAM 4GB〜・GGUF版あり
- 「ZwZ2-9B-GGUF」空間知覚を強化した視覚言語モデル:必要VRAM 8GB〜
- 「MiMo-V2.6-Distill-Qwen-9B-GGUF」:当サイトでの回答例・必要VRAM 12GB〜
- 「clef-omni」30Bのマルチモーダル意思決定モデル:必要VRAM 80GB〜
次に読むなら
- GPUのVRAMから探す(このモデルは4GBの階層から動きます) → 8GBのGPUで動くほかのモデル
- 同じモデル系統を調べる → Qwen3.5 系統のまとめ(記事8本・変換版10件)
- このモデルを動かすエンジンを調べる → llama.cpp / Ollama / vLLM
- 入手できる形式と、表に出てくる IQ2_M・Q5_K_M・Q8_0 の意味を知る → GGUF形式の解説と対応モデル / MLX形式の解説と対応モデル / 量子化・モデル形式の用語集
- 公開元について調べる → Alibaba(Qwen) のモデル・ライセンス・記事のまとめ
出典
更新履歴
- 2026-10-02: 変換版を「派生版・量子化版」に追記しました: bartowski/Cloudflare_clef-flash-GGUF, mlx-community/clef-flash-4bit
- 2026-10-02: 動作環境の表を bartowski/Cloudflare_clef-flash-GGUF の実ファイルサイズで更新しました。
- 2026-10-02: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。
- 2026-10-03: 当サイトでの実測(意思決定モデルとしての判定の評価)を追加しました。
- 2026-10-03: 当サイトでの実測(日本語のトークン効率・GGUFファイルの中身・CPUでの速度と日本語の質問への回答・量子化ごとの劣化)を追加しました。
- 2026-10-03: タイトルを、記事で分かる内容(必要VRAM・配布ファイル等)を示す形に変更しました。
- 2026-10-03: 変換版を「派生版・量子化版」に追記しました: mlx-community/clef-flash-8bit
- 2026-10-05: 変換版を「派生版・量子化版」に追記しました: ggml-org/Clef-Flash-GGUF